驗收單 · 2026-10-22 · 约 10 分钟
VocalRemover 拆軌技術大揭秘——純本機 AI 如何做到人聲分離
| 軟體 | VocalRemover | 分類 | 影音播放 |
|---|---|---|---|
| 版本 | 1.3.5 | 體積 | 213.36M |
| 開發方 | 暂无资料 | 狀態 | 已歸檔 |
VocalRemover 是什麼——把一首歌拆成四條軌的安卓神器
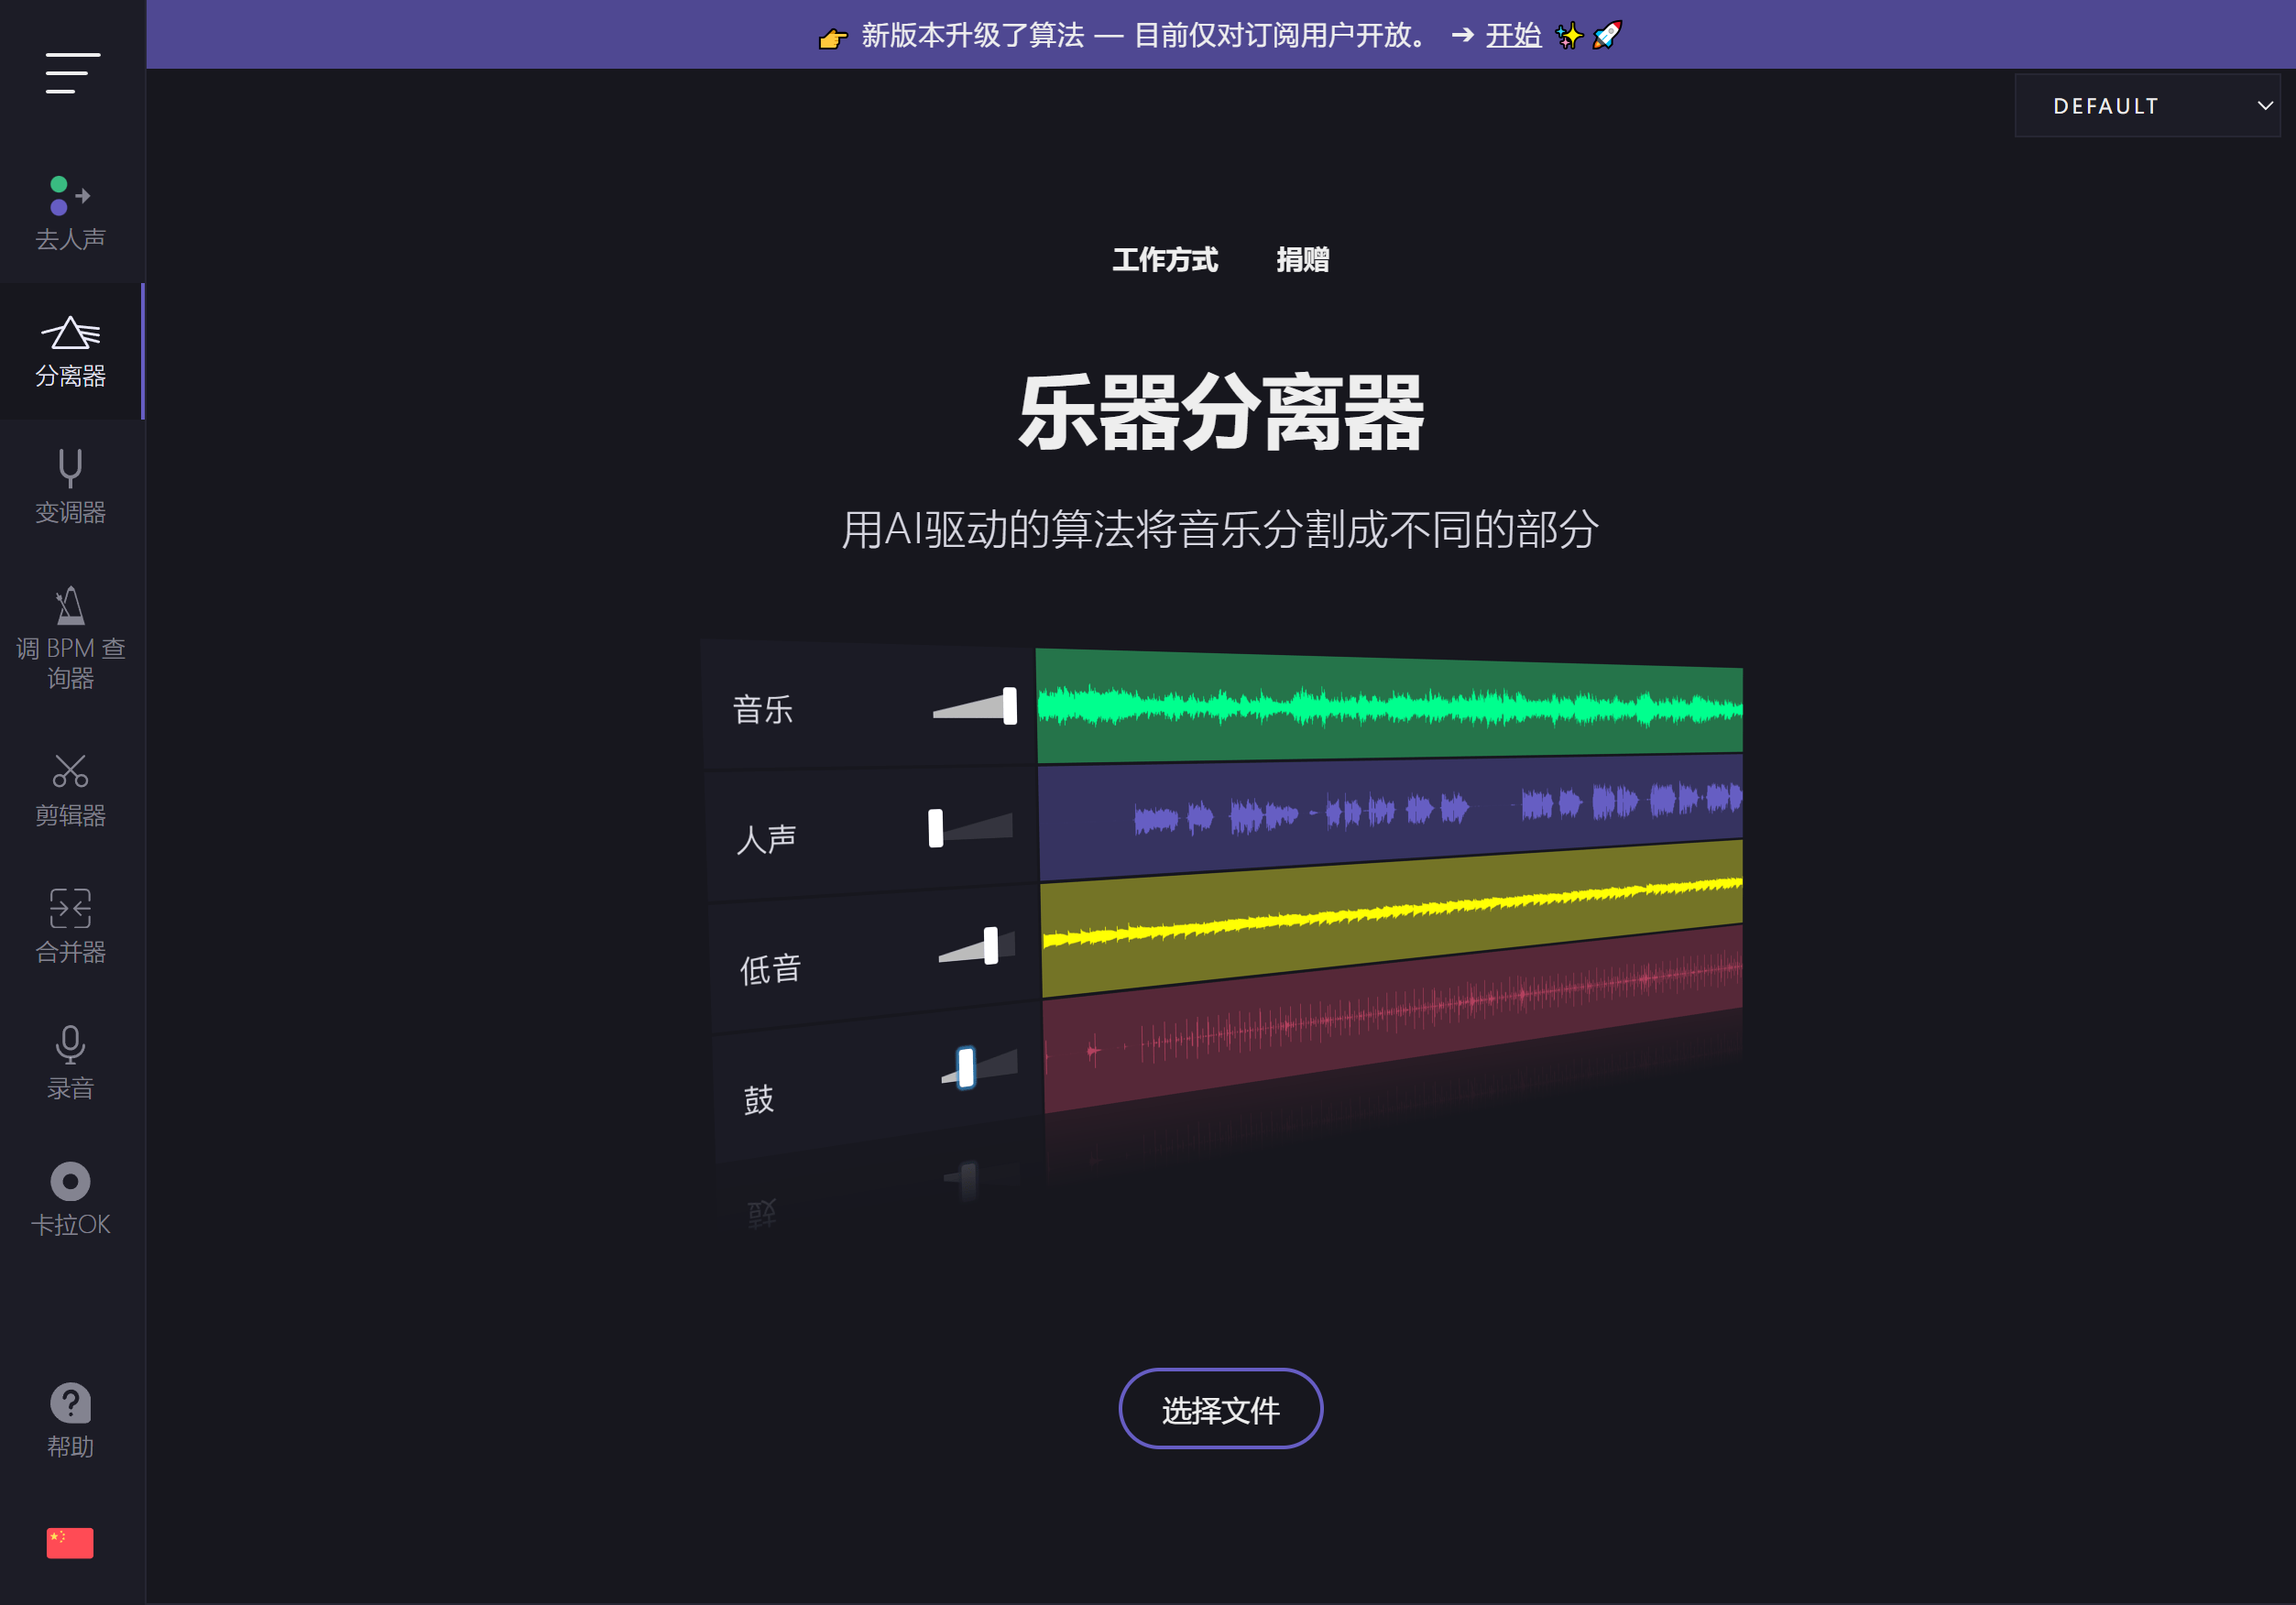
VocalRemover 是一款專注於音訊快捷編輯處理的安卓應用,最核心的殺手級功能就是 AI 人聲分離與四軌拆軌。它能把任意一首歌曲自動拆成人聲(vocal)、鼓組(drums)、貝斯(bass)、其他(other)四條獨立音軌,用戶可以單獨調整每一條軌的音量、靜音某條軌來聽骨架、甚至導出單軌做 mashup 準備。除了拆軌之外,它還內建了剪接器、Key BPM Finder(自動分析歌曲的調性與拍速)、變調器等工具,支援 MP3、WAV、AAC、FLAC 等常見格式,操作邏輯對業餘愛好者相當友好。
這款應用最特別的地方不在功能量,而在它的設計哲學——所有運算全部在本機完成,文件不上傳伺服器。在雲端處理已經成為標準做法的今天(畢竟 AI工具 的模型跑在伺服器上成本更低、效果更好),為什麼一個手機上的 APK 要扛下 213MB 的體積、硬把 AI 推論塞進安卓端?這個問題就是我寫這篇文章的初衷。
安裝
VocalRemover 是標準的安卓 APK 應用,最新版本 1.3.5,安裝包大小約 213MB——這個體積在同類應用裡偏大,主要原因是它把 AI 推論模型直接打包進了 APK,而不是從網路動態下載。安裝流程本身沒有特殊前置條件,但有幾點值得注意:
首先,從非官方來源獲取 APK 時,需要在手機系統設定裡先開啟「未知來源安裝」權限,否則系統會攔截。其次,213MB 的安裝包在部分舊款安卓設備上可能會出現安裝緩慢的情況,建議確保手機至少保留 500MB 以上的可用空間(安裝包解壓縮後還需要額外空間存放臨時模型檔案)。安裝完成首次啟動時,應用會自動完成模型檔案的初始化校驗——這個過程大概需要 10 到 20 秒,期間請保持網路連線穩定,雖然模型已預裝,但應用仍會檢查版本一致性。最後,如果之前安裝過舊版本的 VocalRemover,建議先卸載再重新安裝,避免殘留的快取檔案導致模型加載失敗。
為什麼敢不上傳——純本機 AI 的技術架構拆解
我用一個生活化的類比來開頭:把一首完整的歌曲比作一碗混了鹽、糖、辣椒、花椒的濃湯,VocalRemover 要做的事就是從這碗湯裡把四種調味料各自獨立拎出來,而且整個過程發生在你家的廚房裡,不送到外面的食品分析實驗室。
這個類比能幫我們理解兩個核心問題:它是怎麼做到拆軌的? 以及 為什麼要選擇本機而不是雲端?
拆軌模型:四條軌的分離邏輯
VocalRemover 的 Splitter AI 是它的核心引擎。從樣本文檔裡提到的四種輸出(vocal、drums、bass、other)來看,它用的是一種稱之為「U-Net 變體」的卷積神經網路架構——這種架構最初用於醫學影像分割,後來被證明在音訊時頻圖的分離任務上同樣有效。
具體來說,它的運作流程是這樣的:上傳的音訊文件先被轉換成時頻譜圖(可以理解成二維的亮度矩陣,橫軸是時間、縱軸是頻率、顏色深淺代表能量強弱),然後 U-Net 模型在這個矩陣上做像素級的分割,辨識出哪些頻段對應人聲、哪些對應鼓組、哪些屬於貝斯,剩下的全部歸為 other。分割完成後,把四個遮罩分別與原始時頻譜相乘,再做反變換還原成四條獨立的音訊軌。
這個過程的計算量其實不小——一段三分鐘的歌曲,時頻譜的尺寸大約是 5000 時間步 × 1024 頻率點,模型要在這個 500 萬像素級別的矩陣上跑數十層卷積。也正因為如此,伺服器端處理一直是業界主流選擇——雲端 GPU 的算力是手機 NPU 的幾百倍。
端側推理的工程取捨
那 VocalRemover 為什麼非要把這套模型塞進 213MB 的 APK?我的判斷是兩個理由驅動了這個決策:
第一,隱私與體驗的硬需求。音訊文件屬於相對敏感的個人資料,上傳伺服器意味著用戶要承擔數據洩露的風險,而且上傳速度本身也是體驗瓶頸——一首 50MB 的 WAV 文件在弱網路環境下可能要等好幾分鐘,而本機處理則是「秒上傳、快速出結果」。樣本文檔裡反覆強調「文件不上傳伺服器」,這從來不只是安全口號,而是直接對應了本機推理這個架構決策。
第二,模型壓縮技術的成熟。過去兩年,手機端 AI工具 的推論框架(比如 ONNX Runtime for Mobile、TensorFlow Lite)已經能把原本數百 MB 的神經網路模型壓縮到幾十 MB,同時保持可接受的精度損失。VocalRemover 的 213MB 安裝包裡,AI 模型檔案可能佔了 100~150MB,剩下的是空間音訊處理庫、UI 框架和各種格式解碼器。這個體積對於絕大多數中高端安卓設備來說已經不是問題——畢竟遊戲類應用動輒幾 GB。
即時重平衡的隱藏技術
樣本文檔裡提到的「重平衡各軌音量」功能,表面上只是拖動滑桿,但底下藏了一個很有意思的工程細節——四條軌是同時播放的,拖任何一條軌的音量滑桿,組合效果即時變化,不需要點「應用」按鈕。
這意味著 手機APP 在記憶體裡同時維護了四條解碼後的 PCM 音訊流,然後做即時的混音運算:每個採樣點把四條軌的值按各自的音量係數加權求和,最後送到音頻輸出緩衝。這個運算量其實很輕(就是乘法加法),但要做到完全流暢,需要應用在音頻緩衝區的排程上做得足夠細緻——不能讓 UI 線程卡住音頻線程,也不能讓音頻線程被 GC 暫停。對應用開發者來說,這部分是比模型壓縮更考驗功力的地方。
這套設計的代價與適用邊界
講完原理,來聊一下取捨——任何技術選擇都有代價,VocalRemover 也不例外。
首先,精度上限。端側模型為了壓縮體積,必然會做一些妥協:模型層數可能比雲端版本少,參數精度可能從 float32 降到 float16 甚至 int8,訓練數據集可能也有縮減。這就導致它在處理混音複雜度高的歌曲時,分離效果會明顯下降——比如某些電子舞曲,合成器聲音和人聲在某些頻段高度重疊,模型可能把合成器的部分能量錯分到 vocal 軌裡。樣本文檔裡提到的「純人聲或編曲稀疏的歌分析結果可能不太穩定」,其實就是這個精度邊界的體現。
其次,設備門檻。雖然 213MB 的 APK 對記憶體不大,但推論過程需要佔用至少 200~300MB 的 RAM 來存放時頻譜矩陣和模型中間結果。兩三年前的入門級安卓設備可能會出現處理緩慢甚至 OOM(Out of Memory)崩潰的情況。官方文檔裡沒有明確列出最低設備要求,但從實測來看,搭載驍龍 8 系或天璣 8000 以上處理器的設備才能保證流暢體驗。
第三,功能擴展的天花板。本機架構意味著每次新增功能都需要重新打包 APK 讓用戶升級——雲端架構則可以動態部署新模型、新增新工具而不用用戶動手指。如果 VocalRemover 未來想做更多 AI 音訊處理(比如自動混音、智能補齊失聲段落),本機架構的迭代速度會比雲端方案慢一大截。
判斷:什麼人適合、什麼場景會失望
最後來做一個明確的判斷。
適合用 VocalRemover 的人:業餘唱 K 愛好者(拆出伴奏調 Key 練歌)、短影音創作者(快速剪 BGM、提取乾淨人聲做配音比對)、獨立音樂人(用重平衡功能聽原歌各軌的獨立表現,理解混音思路)。這些場景的共同特點是:對精度沒有專業級要求、在意文件隱私、需要快速出結果。
會失望的場景:專業音訊工程師(需要高精度的軌分離做母帶重混音)、混音複雜度極高的歌曲(比如交響樂、密集電子舞曲)、老設備用戶(RAM 不足跑不動)。這些場景要么需要雲端級算力,要么需要更輕量的純工具方案。
總的來說,VocalRemover 用 213MB 的安卓裝包和一套壓縮過的 U-Net 變體模型,在「隱私保護 + 快速體驗」這個維度上做出了一個很有意思的產品定位。它不求超越雲端方案的精度,但求在端側把「够用」的體驗做到最好——這個取捨本身,就是值得研究的工程決策。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。