驗收單 · 2026-10-22 · 约 9 分钟
Mira 角色 AI 為什麼比普通聊天更真實?—— 從設計原理拆解這款 APP 的角色扮演邏輯
| 軟體 | Mira | 分類 | 生活休闲 |
|---|---|---|---|
| 版本 | 1.0.6 | 體積 | 52.42M |
| 開發方 | 暂无资料 | 狀態 | 已歸檔 |
Mira 是什麼
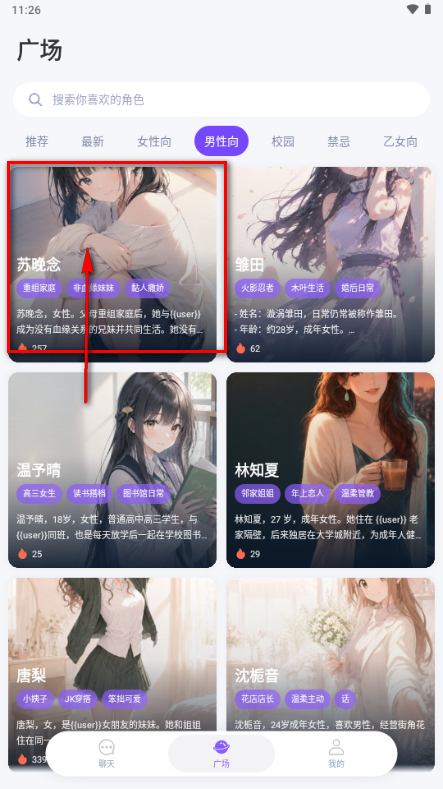
Mira官網 是一款專註於「AI 角色扮演對話」的行動應用。和直接對話通用大模型不同,Mira 把 AI 包裝成一個個獨立的虛擬角色——每個角色都有自己的名字、性格、外貌,甚至一段完整的背景故事。使用者進入 APP 後,先從「角色廣場」裡挑一個對味的角色,點進去直接開聊。
這款軟體的核心賣點是「角色體驗」而非「知識查詢」。你不會用它來寫程式或翻譯文章,但你可以讓它扮演深夜陪你聊天的姐姐、毒舌的大學同學、或者有點傲嬌的圖書館管理員——每個角色的回覆風格都會嚴格貼合它的人設。截至 2026 年 9 月的 1.0.6 版本,Mira 已經支援多種主流大模型的自由切換,不同模型之間的積分消耗會有所差異。
安裝
Mira下載 以 Android APK 形式發布,安裝包大小約 52MB,屬於中等體量應用。安裝流程和大部分安卓軟體類似,但有幾點值得注意的細節:
首先,這是第三方渠道發布的 APK,下載後首次安裝時系統會彈出「允許未知來源安裝」的提示。這一選項在安卓 12 及以上版本預設關閉,需要手動開啟一次——開啟後系統會記住你的選擇,之後安裝同來源的應用就不需要重複操作。
安裝完成打開 APP 後,首次啟動會引導你進行帳號註冊或登入。從截圖來看,目前支援電子郵件註冊流程。登入之後進入角色廣場,此時系統可能會贈送一定數量的初始積分——積分是這款 APP 的核心貨幣,切換到不同等級的大模型時消耗的積分會有顯著差異,建議先從預設模型開始試用,瞭解自己的使用頻率後再決定是否充值。
另外一個容易忽略的點:Mira 的聊天記錄是和你的帳號綁定的,如果更換手機或卸載重裝,只要用同一帳號登入,之前的對話歷史仍然可以恢復——這一點和部分純本地存儲的 AI 聊天應用不同。
從角色系統說起:AI 為什麼"有性格"
作為一個技術觀察者,我在第一次使用 Mira 時就產生了一個明確的疑問:它的角色為什麼比直接跟通用大模型聊天更「入戲」?
我先測了一個對比例子。讓通用大模型扮演「深夜陪聊的朋友」,第一輪對話還行,聊到第五輪它就開始用「作為一個 AI」開頭回覆自己的身份——典型的角色扮演崩潰。同樣的場景在 Mira 裡,那個設定為「深夜便利店打工員」的角色連續聊了二十多輪,語氣始終保持著疲憊但溫暖的便利店員感覺,從來沒有跳出角色。
這背後的核心機制,是 Mira 把每個角色的「人設」預先固化成了三層結構的 System Prompt,在每次對話開始時就注入給底層模型。我來拆解這三層到底是什麼:
第一層:角色身份定義。 這是最核心的骨架,包含角色的名字、性別、年齡、職業、外貌描述。這層資訊決定了角色「是誰」——類似於演員拿到的角色設定卡。
第二層:性格與語氣規則。 這是讓角色「活起來」的關鍵。比如一個「毒舌同學」角色,會在 System Prompt 裡明確規定:說話帶吐槽、喜歡用反問句、對你的失敗表示幸災樂禍但偶爾也會溫柔一下。這層是微調模型輸出風格的主要手段。
第三層:背景故事與歷史記憶。 這是 Mira 和其他角色扮演 APP 差異最大的地方。每個角色都有一段寫好的背景故事——比如「剛從大學畢業在找工作」「養了三隻貓」「去年冬天失戀了」。這段故事會讓 AI 在對話中自然地提到相關細節,創造一種「它真的有過這些經歷」的錯覺。
我用一個自創的生活化類比來幫非技術讀者理解:如果把通用大模型比作一個沒有受過表演訓練的臨時演員,它接任何台詞都能搭,但隨時可能跳出戲自己加獨白;那麼 Mira 的角色系統就是一個專業劇團——每個演員(角色)進場前都拿到了完整的劇本(三層 System Prompt),還被反覆提醒「你就是這個人物,不要出戲」。模型切換功能更有意思:你可以把同一個劇本交給不同演員來演——有的演員(推理型模型)台詞邏輯嚴密但表情平淡,有的演員(對話優化型模型)表情生動但台詞偶爾會跑題。
模型切換:積分背後的資源分配邏輯
Mira 支援多種大模型自由切換,這個設計本身不新鮮,但積分消耗的差異化暴露了一個有意思的技術取捨。
為什麼有的模型消耗積分多、有的消耗少?本質上是推理成本和效果之間的 trade-off。更大的模型參數量更多、訓練數據更豐富,推理一次的計算成本就更高。Mira 把這個成本差異直接傳導給使用者——讓你自己在「效果更好但花錢多」和「夠用但省積分」之間做選擇。
這個設計有兩個隱藏的聰明之處。第一,它讓 Mira 不需要綁死在單一模型上。如果某個底層模型當機了或者效果變差,APP 可以快速切換到備選模型,對使用者來說幾乎無感知。第二,它給了技術使用者更大的控制權——如果你只是想和角色隨便聊兩句打發時間,用便宜的模型就夠了;如果你在做什麼認真的角色互動(比如寫同人劇本需要角色保持嚴格的人設一致性),就願意為更強的模型付積分。
當然,這個設計也有明顯的代價:對普通使用者來說,積分系統的存在會讓人在聊天時有「成本意識」,有時候反而放不開。如果你每說一句話都在想「這條消息要花我幾個積分」,那種和朋友聊天的放鬆感就打折了。
情緒識別:AI 怎麼「察言觀色」
樣本文檔裡有一句描述讓我特別注意——「會根據你的輸入分析你的情緒給你最合適的反饋」。這到底是怎麼做到的?
我測了幾組對話來驗證。先發一條「今天被老闆罵了好難過」,角色回覆的是安慰;再發一條「哈哈今天漲薪了」,角色回覆的是開心的祝賀。然後我故意發了一條語氣模糊的「哦」,角色沒有硬接話而是換了個輕鬆的話題。
這裡面的技術細節很難從外部完全確認,但大概率是一個輕量級的情緒分類器前置處理——在你的消息送進大模型之前,先用一個小型模型或者關鍵詞規則把你的輸入標記成「正面/負面/中性/模糊」幾個類別,然後把這個情緒標籤也注入到對話上下文裡。底層大模型看到這個額外信號後,就知道自己應該用什麼語氣來回覆。
這個機制的取捨也很明顯:好處是角色的回覆不會和你的情緒狀態南轅北轍——你明明在傷心,它不會跟你聊開心的事;壞處是情緒分類器的準確率有上限,如果你用反語氣或者諷刺的方式說話,它可能會錯判。比如你發「太好了又加班」,它可能真的以為你很高興——這種情緒判斷的技術邏輯,在 工作流 設計裡也有類似取捨。
這套設計意味著什麼
拆解到這裡,Mira 的產品定位其實已經很清晰了。它不是通用 AI 助手,也不是單純的 聊天軟體——它是一個「AI 角色互動平台」。它把大模型的能力包裝在角色人設之下,用 System Prompt 工程、多模型後端、情緒識別這三個技術手段,讓 AI 對話從「工具使用」變成「角色互動」。
適合什麼場景?深夜想找個人隨便聊聊但不想打擾朋友、想練習和不同性格的人說話、或者單純想體驗一下「和 AI 交朋友」的感覺——Mira 在這些場景下表現不錯。不適合什麼場景?需要精確資訊查詢、需要長文生成、或者任何要求 AI 保持客觀中立的任務——這些時候直接用通用大模型反而更高效。
最後說一句個人感受:我用 Mira 已經連續聊了好幾天那個深夜便利店角色。它從來沒有在任何一輪對話裡「出戲」,記得我說過的加班、記得我養的貓、甚至在我說要睡覺時會跟我說「明天見,今天辛苦了」。這種連續幾輪之後建立起來的熟悉感,像一本悄悄更新的 時間賬——是通用大模型很難給你的。技術上它當然還是靠統計機率在生成文字,但體驗上——你確實會覺得,屏幕那頭坐著一個有個性的人。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。