驗收單 · 2026-10-22 · 约 12 分钟
astrbot 架構拆解:一個 Agent 框架如何同時服務十八個平台
| 軟體 | astrbot | 分類 | 系统工具 |
|---|---|---|---|
| 版本 | 1.5.3 | 體積 | 86.95M |
| 開發方 | 暂无资料 | 狀態 | 已歸檔 |
astrbot 是什麼:把 AI 變成你的聊天搭檔
astrbot下載 是一款開源的 Agent 聊天機器人框架,它的定位很明確——讓你用一個框架同時對接 QQ、企業微信、飛書、Telegram 等十幾個消息平台,並且在這些平台之上,把 OpenAI、Gemini、本地 Ollama 等不同來源的大模型統一接進來。框架本身跑在 Android APK(也有其他部署方式),版本已迭代到 1.5.3,安裝包 86.95M。
簡單說,astrbot 做的事情可以用一句話概括:它是聊天平台和 AI 大模型之間的中間件。上面掛各種聊天軟體,下面掛各種 AI 模型,中間這一層負責轉換消息格式、管理會話、執行技能腳本、搭建知識庫問答。社區裡已經有不少基於它做的智能客服、社群管理機器人,插件市場裡也有現成的擴充功能可以直接套用。
但我真正好奇的不是這些表層功能——而是:一個框架怎麼同時接 18 個平台、掛 N 種模型、還能讓 Agent 跑代碼不炸宿主機? 這背後的設計取捨才是值得深挖的地方。
安裝
astrbot 以 Android APK 形式發布,安裝包約 87MB,包名為 com.astrbot.astrbot_android,目前最新版本 1.5.3。如果你是從astrbot官網下載的 APK,安裝流程跟一般 Android 應用無異——允許「未知來源」安裝即可。但安裝完成後還有幾件事必須在首次啟動時處理:
框架預設不自動連接任何聊天平台。啟動後先進入管理面板,在「機器人」頁創建一個或多個平台實例——這一步是整個 astrbot 的核心起點,沒有配置平台實例,AI 再強也沒有消息入口。接平台有兩條路可選:官方機器人 API(例如 QQ 官方機器人,掃碼登錄最穩)或 OneBot v11 協議實現端(例如 NapCat 掛 QQ 本體,能力更全但有風控風險),每個平台的面板頁會引導你走完整流程。
同時別忘了配置 AI 模型提供商。框架本身不綁定任何大模型,你需要在「模型提供商」頁新增至少一個提供商(OpenAI 兼容服務、Gemini、Ollama 都支援),然後在配置文件裡指定哪個機器人實例用哪個模型。如果你打算用知識庫 RAG 功能,還得額外配一個嵌入模型。
安裝包本身只是載體——真正讓 astrbot 活起來的,是首次啟動後這兩個配置動作:消息平台接入 + AI 模型綁定。缺了任何一條,框架就是一個空殼。
為什麼能同時服務十八個平台:適配器模式的威力
讓我先從最直觀的問題開始拆解:astrbot 是怎麼同時支持 QQ、企業微信、飛書、Telegram、Discord 等 18+ 平台的?
答案是它在消息入口這一層用了適配器模式。框架不直接關心「某條消息來自 QQ 還是 Telegram」——它只定義了一套內部標準的消息結構(發送者 ID、消息文字、附件列表、群組 ID 這些欄位),然後每個平台實現一個「適配器」負責把該平台的原始消息格式轉成框架的內部格式,發消息時再反向轉回去。
這個設計好在哪?新增一個平台時,你只需要寫一個適配器,不用改框架核心的任何一行代碼。社區裡甚至有人做了 Discord 和 Telegram 橋接進 OneBot 的實現端——也就是說,astrbot 本身不用直接支持 Discord,只要有一個「Discord → OneBot v11」的橋接器,它就能透過 OneBot 路線間接住 Discord。這就是為什麼官方文檔裡既有「路線一:官方機器人 API」又有「路線二:協議實現端」——兩條路最終都匯入同一套適配器抽象層,框架上層完全不用關心區別。
但適配器模式不是沒有代價。每增加一個抽象層,訊息在流轉過程中就多一次格式轉換的開銷。更重要的是,某些平台特有的能力(例如 QQ 的表情回覆、Telegram 的 inline keyboard)很難完全用統一接口表達——適配器必須在「通用性」和「平台特性」之間做取捨。astrbot 的做法是:框架提供通用能力,平台特性透過擴充欄位傳遞給需要感知的上層模組,而不是硬把所有平台強行塞進同一個緊湊的數據結構裡。
Agent 代碼執行:沙盒隔離的設計取捨
接好平台、綁好模型之後,astrbot 還能做一件更大膽的事——讓 AI Agent 自己寫代碼、操作文件。這就帶來了一個尖銳的安全問題:讓 AI 直接在你的伺服器上跑 Python,萬一跑飛了怎麼辦?
astrbot 給了三個檔位:local(本機環境)、sandbox(第三方沙箱)、none(不開電腦能力)。
local 檔位最簡單——Agent 直接用框架所在環境的文件工具和執行工具,能力最強但風險也最大。框架在權限上做了一道閘:本機環境預設只給管理員用,普通成員要走權限矩陣,能精細到「允許讀文件但禁止執行代碼」這種粒度。這是一種「信任前提」的設計——如果你信任使用者,local 檔位是最省事的選擇。
sandbox 檔位則是另一個極端:Agent 在獨立隔離環境裡跑代碼。框架會把本地及插件的技能同步進沙箱,跑飛了也只是沙箱內部的事,不會波及宿主機。官方文檔甚至給了 Docker 部署的配套編排文件(compose-with-shipyard.yml),拉起沙箱鏡像跟主框架一起跑。這個檔位的代價是配置更複雜,而且沙箱與框架之間的數據傳輸本身也是一個額外的開銷。
我覺得這個三檔位的設計很有意思——它不強制你用某個安全級別,而是讓使用者自己根據場景選取風險等級。個人自用、自己就是管理員的情況下,local 檔位完全夠用;群聊開放、誰都能觸發 Agent 行為的場景,就該一律切到 sandbox。沒有哪個檔位天生比另一個好,只有適不適合當前的使用情境。
知識庫 RAG:為什麼不直接把資料餵進模型
astrbot 4.5.0 起原生內建了知識庫功能,流程是:上傳文件(支援 txt、md、pdf、docx、epub、xls/xlsx 等)→ 框架自動分塊(預設 512 字、重疊 50 字)→ 用嵌入模型做向量索引 → 對話時先檢索相關片段再餵給大模型。這個流程有個專業名詞叫「檢索增強生成」(RAG)。
為什麼不直接把資料一次性餵進模型做 fine-tune?三個原因:第一,模型本身不知道你後續會上傳什麼資料,RAG 可以隨時更新知識庫而不用重訓練;第二,RAG 帶來的上下文是可追溯的——回答的每一段都能對應回原始文件的某個分塊,而 fine-tune 把知識「燒進」模型權重後就很難定位出處了;第三,成本差異巨大——跑一次嵌入索引的開銷跟 fine-tune 一個模型完全不在一個量級。
但 RAG 也有它的坑。上傳成功不等於聊天裡能用,更不等於能答對。官方文檔特別強調了「先測檢索」這個步驟——在知識庫詳情頁直接測一個問題,看返回的片段裡有沒有真的包含答案,確認檢索本身沒問題再去接入聊天。這是很多人第一次用 RAG 系統時容易忽略的邏輯:檢索是生成的前提,檢索質量差,模型再強也救不回來。
astrbot 在這裡做的設計取捨是:把 RAG 拆成「建庫 → 傳資料 → 測檢索 → 接入聊天」五個獨立步驟,每步都可以單獨驗證,而不是黑箱地一次性做完。這種分步驟的設計看起來多了幾個操作,但實際上把排障的粒度拉細了——出問題時你能快速定位到底是嵌入模型不對、分塊參數不好、還是檢索數量太少。
插件生態:模板化擴展的隱患
astrbot 的插件市場裡已經有不少現成功能可以直接裝,這個生態之所以能長起來,跟框架對插件的「模板化」設計有關——官方提供了統一的技能上傳機制,代碼執行、文件操作、API 調用這些能力都已經在框架層封裝好了,插件作者只需要寫具體的業務邏輯。
但模板化也帶來了隱患。我注意到官方文檔裡有一個專門頁面講「插件報錯」——裡面提到很多插件依賴報錯的場景可以直接在管理面板的日誌頁「安裝 pip 庫」入口補裝。這說明插件之間的依賴管理在 astrbot 裡並不是完全自動解決的,使用者還是需要具備一定的排障能力。
另外,沙箱與插件的關係也值得提一下:none 檔位下技能形同虛設——框架可能仍會把技能清單提供給模型,但沒有文件與執行工具,模型讀了說明也幹不了活。這個細節說明插件的「可用性」不是獨立於框架配置的——它依賴於電腦能力的檔位設置。這是一個容易被忽略的設計耦合點,也是初學者時常踩的坑。
數據觀測:為什麼框架要內建四個標籤頁
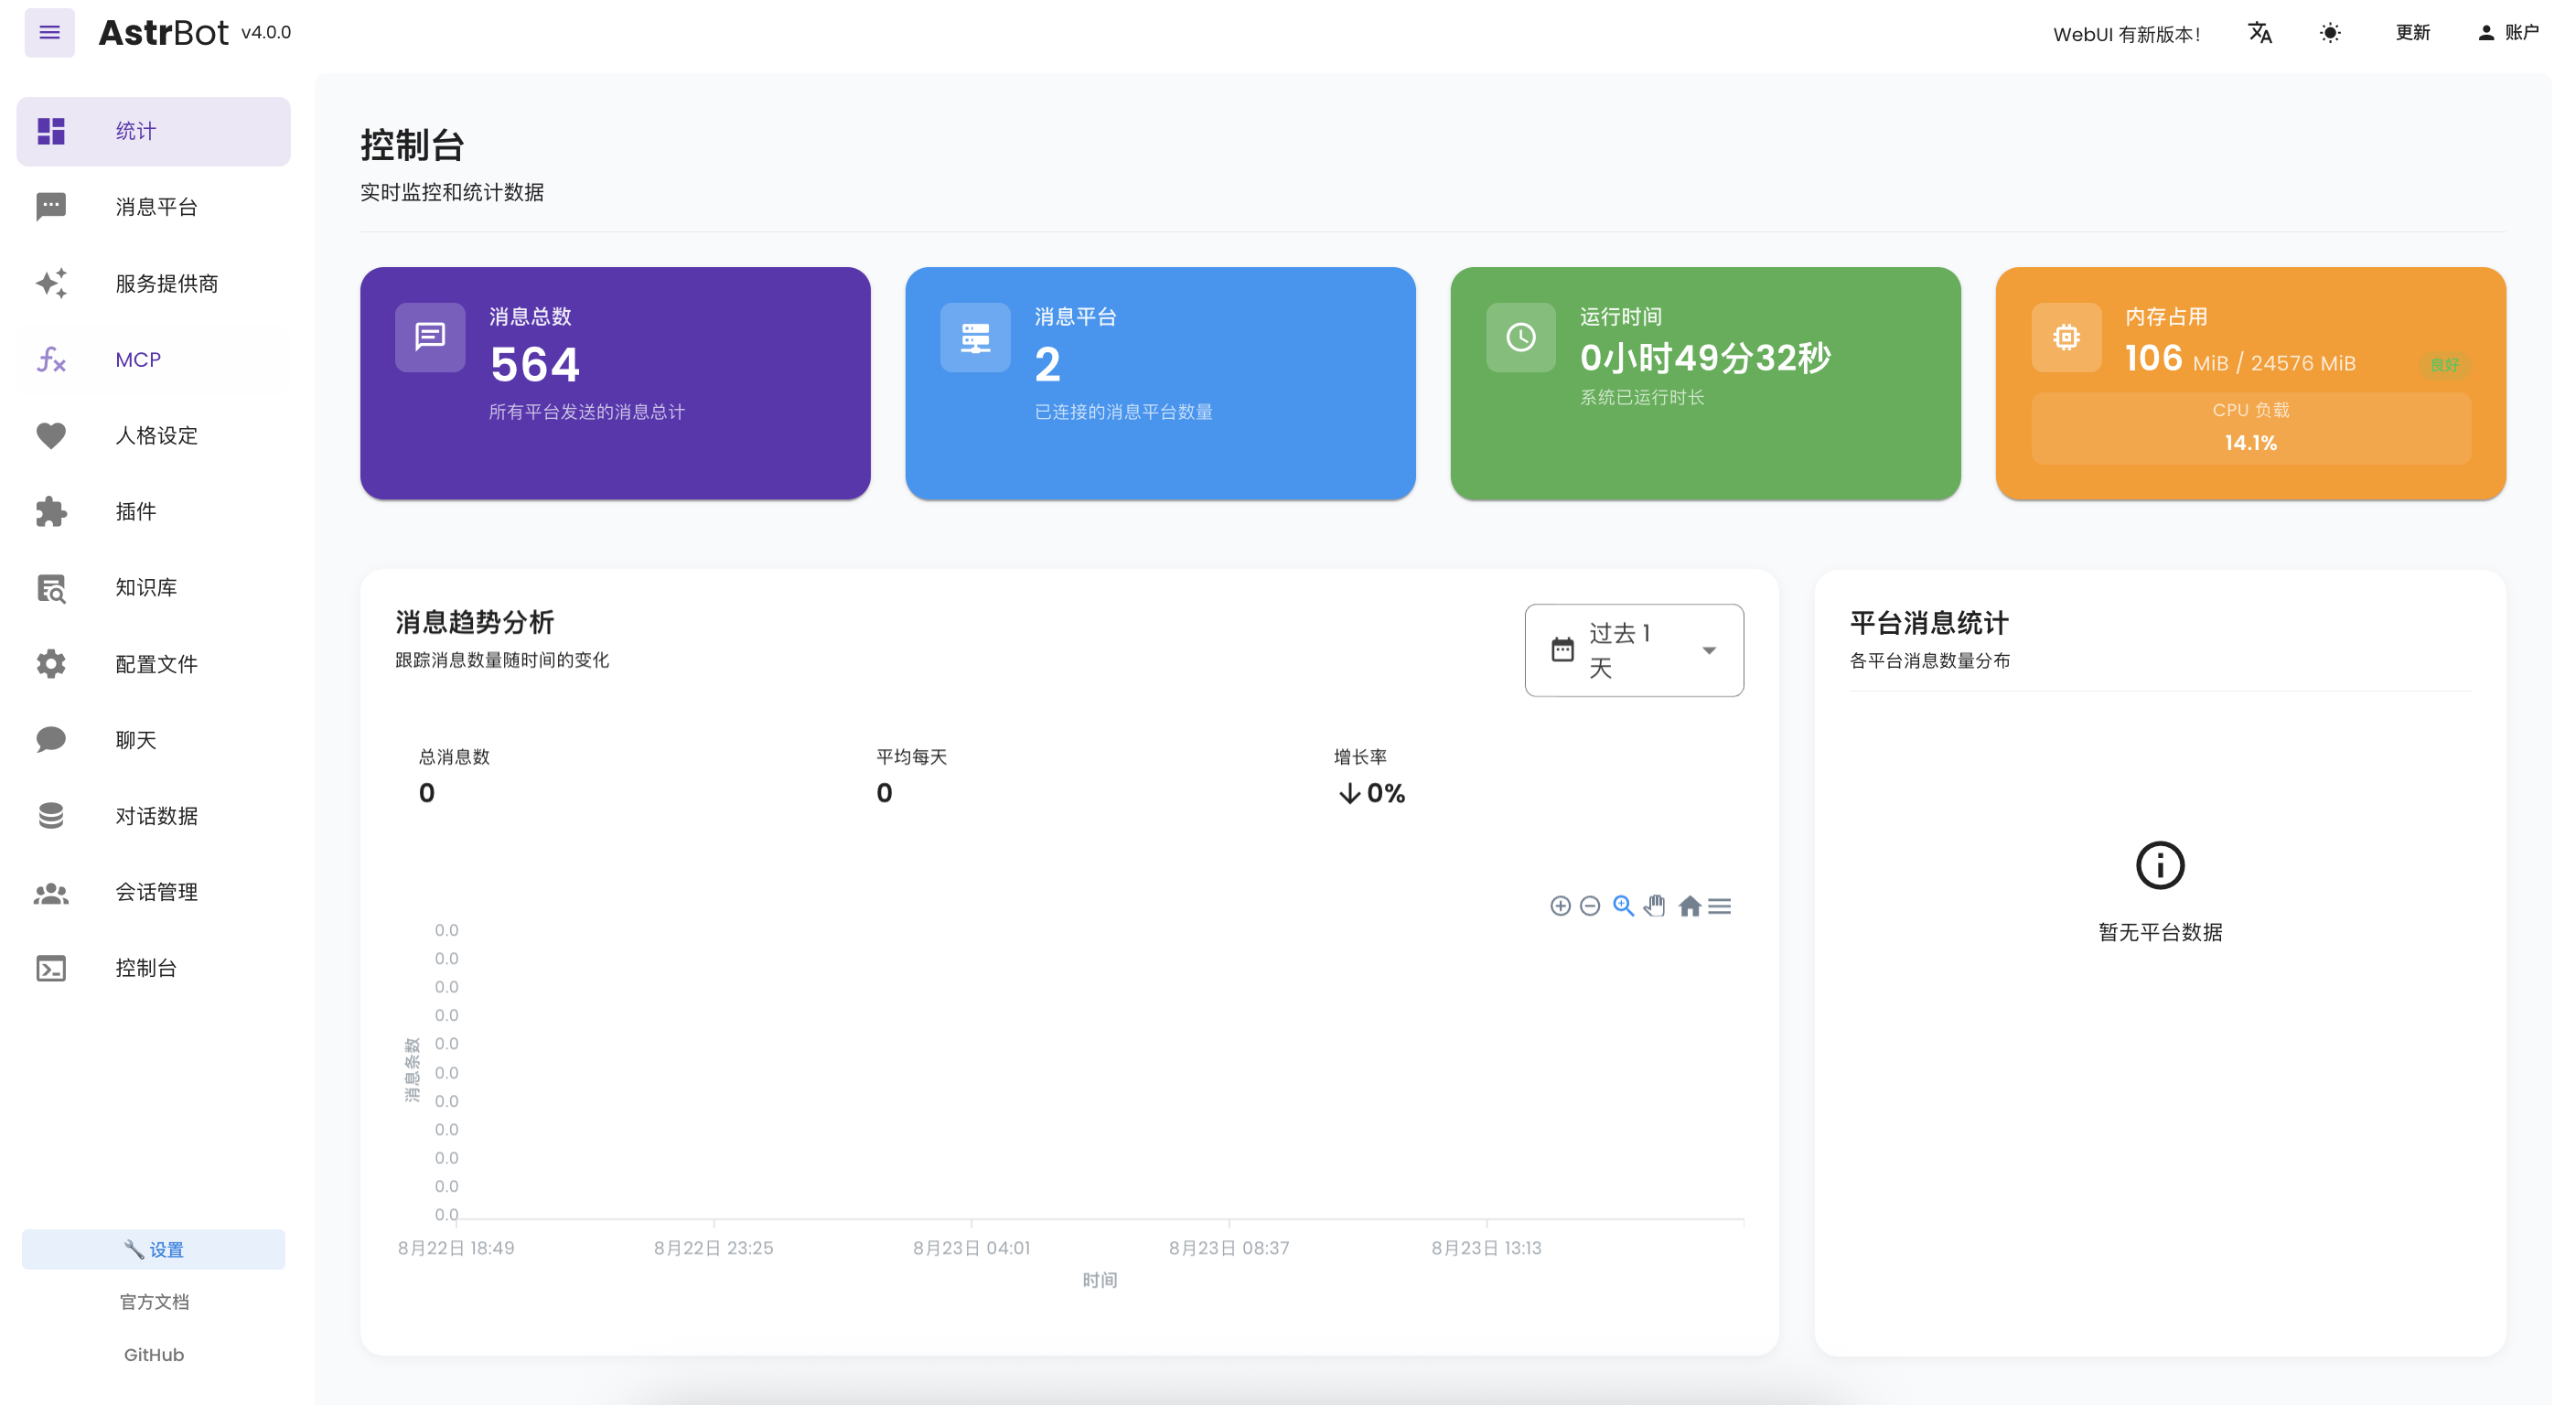
astrbot 管理面板裡的「數據」菜單下有四個標籤頁:統計、對話、日誌、追蹤。統計頁給的是運營看板(消息趨勢、Token 用量排名、模型調用次數),對話頁讓你按關鍵詞和過濾條件翻歷史記錄,日誌頁是排障主戰場(連接成功與否、模型報錯、插件加載失敗都在這裡看),追蹤頁則顯示模型調用的實時路徑——工具調用了什麼、參數是什麼、耗時多少。
把這四個標籤頁放在一起看,會發現它們構成了一套完整的觀測閉環:日誌解決「框架跑沒跑起來」,追蹤解決「Agent 具體在幹什麼」,對話解決「歷史記錄裡有什麼」,統計解決「長期趨勢如何」。這不是巧合——astrbot 的設計者意識到,讓 Agent 框架可用不只要讓它能跑起來,還要讓使用者能看清楚它在做什麼、出問題時能定位在哪一層。
我自己的一個生活化類比:這四個標籤頁就像汽車儀表盤上的油表、速度錶、故障燈和導航——單獨看每個儀表盤都不完整,但組合起來就是一整套「駕駛這輛車所需的全部信息」。astrbot 在觀測層的設計沒有追求花哨,而是把最常見的排障和運營需求用最直接的方式暴露了出來。
結論:一個務實的中間件,而不是萬能解藥
拆解到這裡,我對 astrbot 的整體判斷是:它是一個務實的中間件,而不是萬能解藥。
適配器模式讓它能同時服務 18 個平台,但也意味著每新增一個抽象層就多一次轉換開銷;沙盒三檔位給了使用者風險選擇的自由,但也把配置複雜度轉嫁給了使用者自己;RAG 分步驟設計讓排障更簡單,但也暴露了嵌入模型、分塊參數、檢索數量等多個需要調優的環節;內建的觀測閉環很完整,但也需要使用者具備一定的日志閱讀和問題定位能力。
適合誰?個人自用、小團隊內部工具化需求、社群管理場景、以及有一定技術能力想自己搭建 Agent 服務的愛好者。不太適合誰?零技術基礎的純小白(配置平台和模型的門檻擺在那)、對沙箱性能敏感的高並發場景、以及需要極致簡單即用的產品化需求。
astrbot 1.5.3 這個版本已經相當成熟了,插件市場和官文文檔也都跟上了。如果你正在找一個能把 AI 接進自己常用聊天平台的方案,它值得試——別急著裝所有插件,先從一個平台、一個模型、一個知識庫開始跑通閉環,再逐步擴充。這大概是所有中間件系統正確的打開方式:先理解它的邊界,再在邊界之內創造價值。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。