驗收單 · 2026-10-22 · 约 10 分钟
qwen3 深度盤點——從量化部署到多模態視覺的全方位能力速覽
| 軟體 | qwen3 | 分類 | 系统工具 |
|---|---|---|---|
| 版本 | 1.9.0 | 體積 | 40.53M |
| 開發方 | 暂无资料 | 狀態 | 已歸檔 |
qwen3 是什麼
qwen3 是阿里巴巴旗下推出的 AI 助手產品,定位於「全能型」的端雲結合智能體——它既可以在手機上以 App 形態離線或半離線運行,也可以透過阿里雲百煉平台的雲端 API 調用規模更大的模型。作為 Qwen 系列大模型的第三世代,qwen3 在中文能力、多語言覆蓋、推理深度與多模態整合上都有長足進步,尤其適合中文為主的使用者。
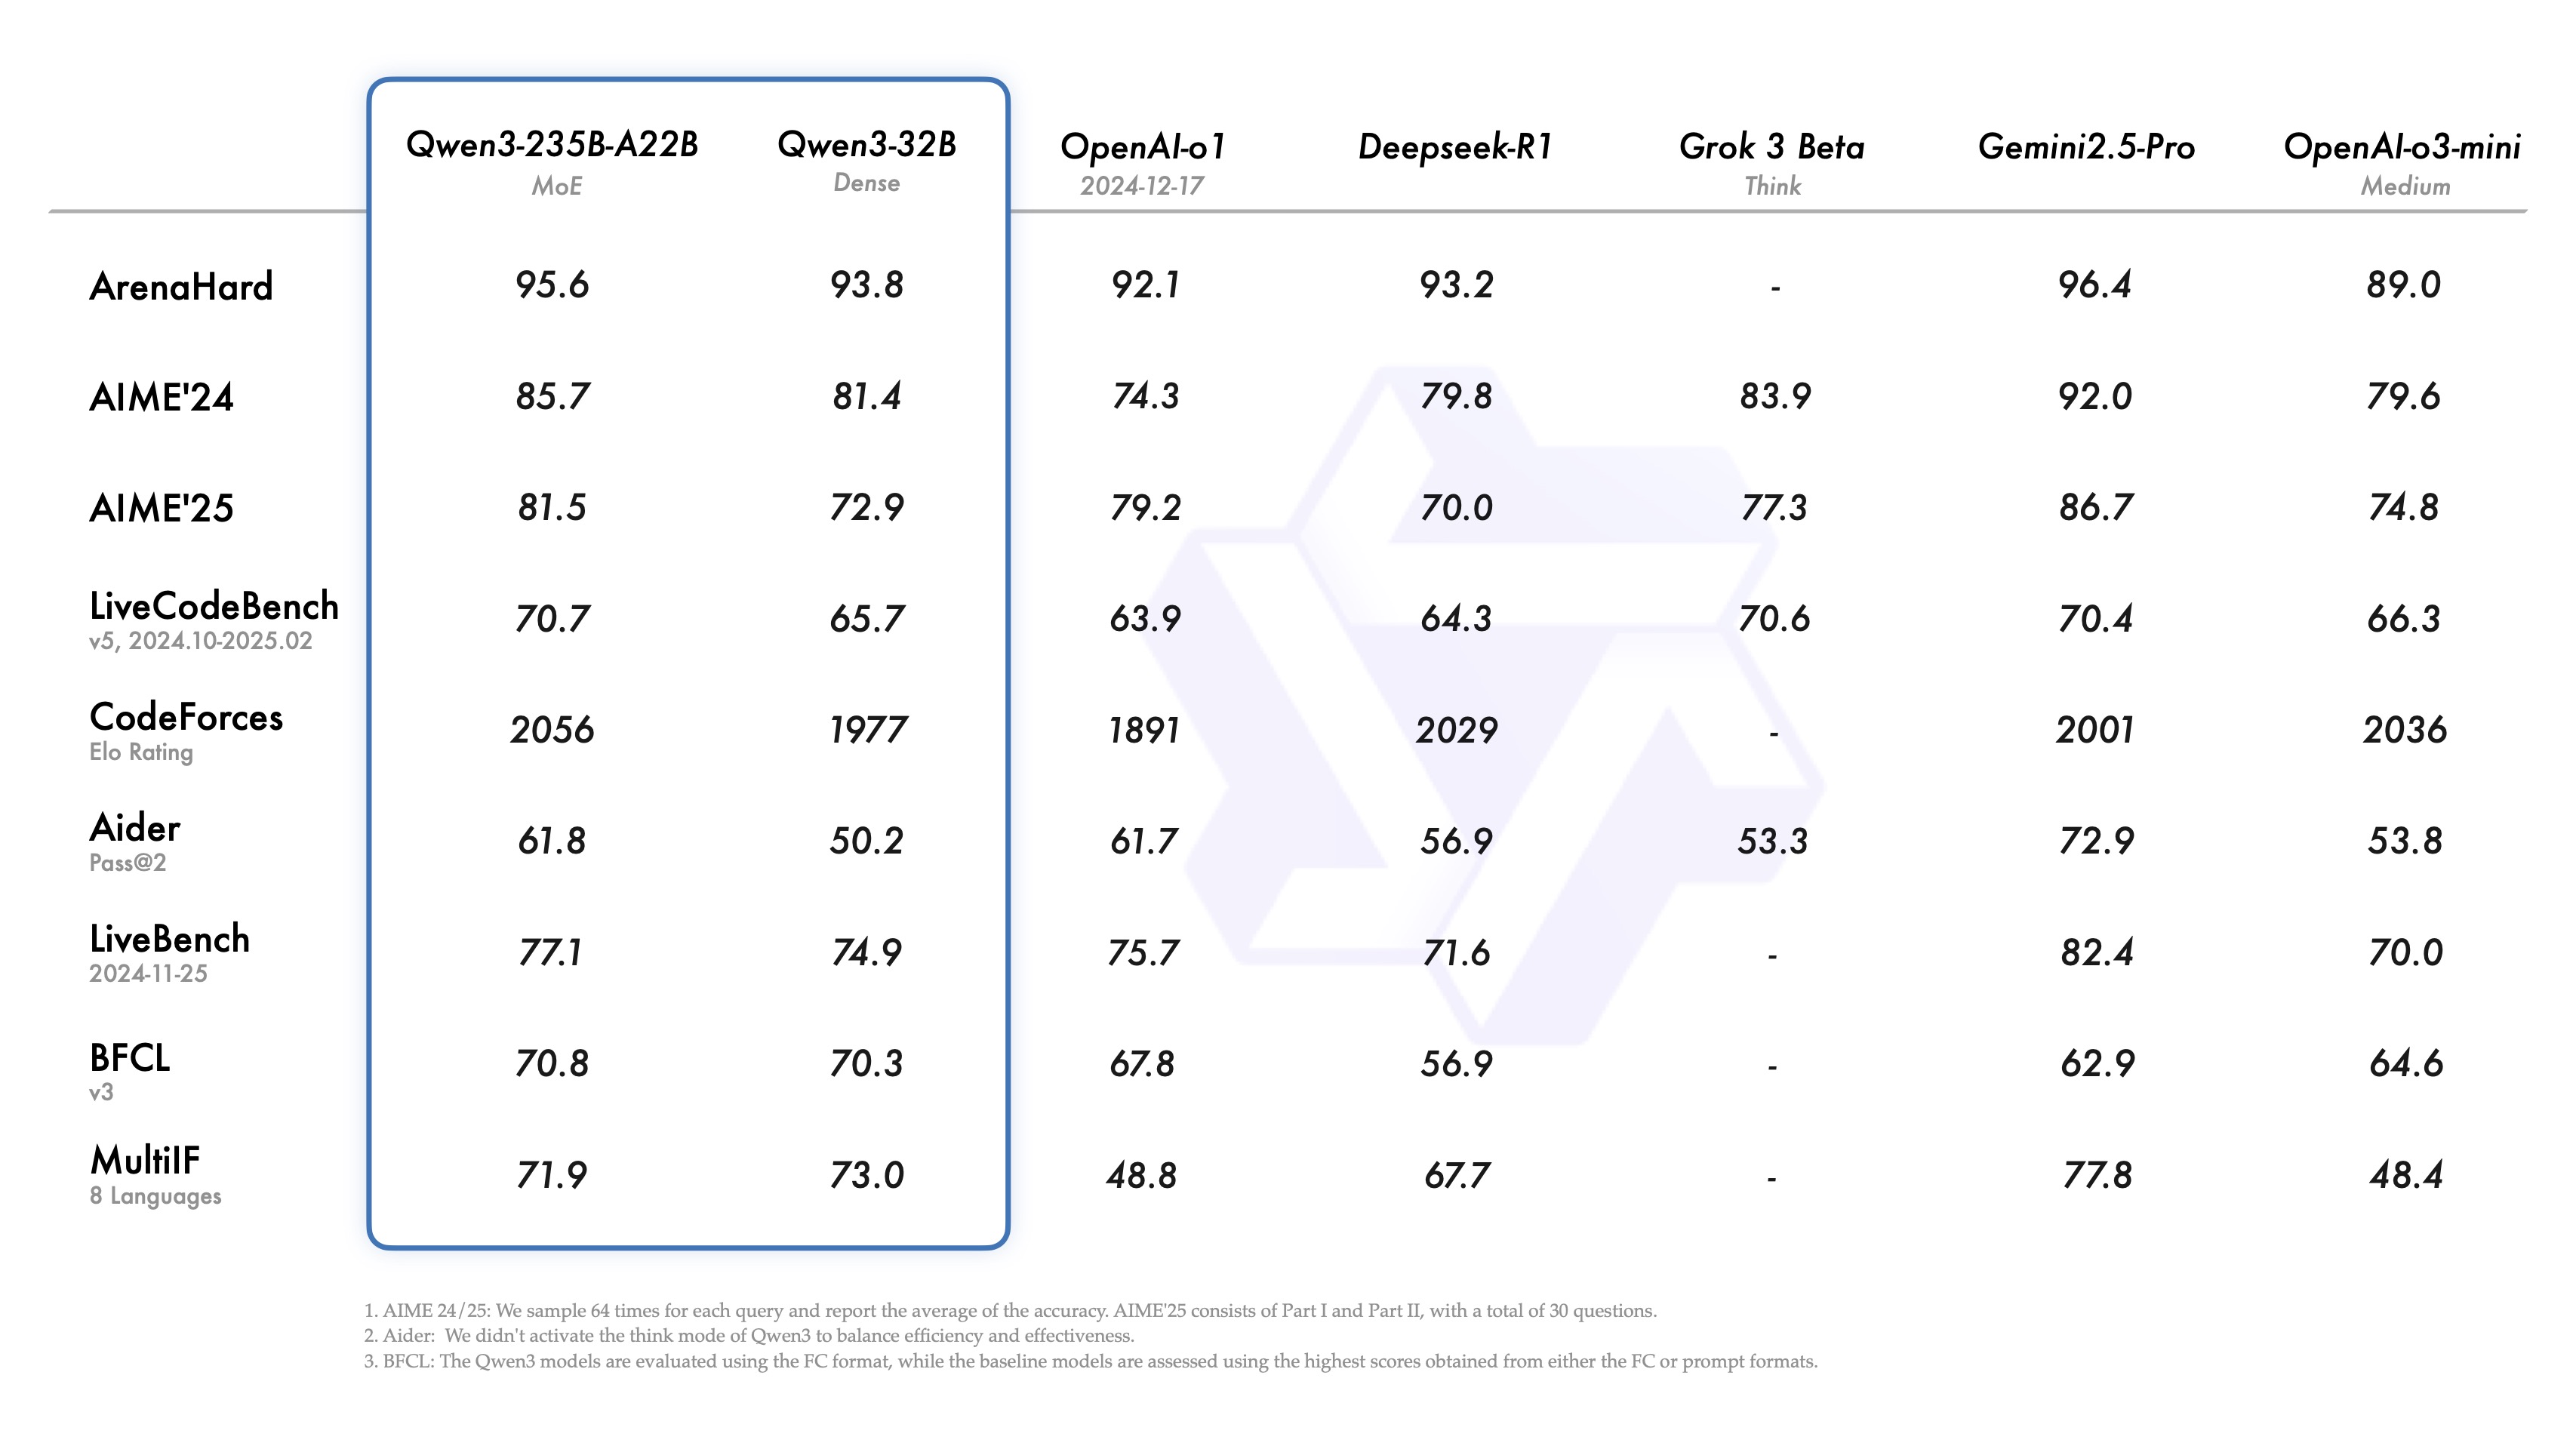
從已發布的基準測試來看,qwen3-235B-A22B 作為開源旗艦規格,在中文 C-Eval 基準上約 90%(思考模式),顯著超過 Llama 3.1 與同期英文主導模型;MMLU 英文知識約 78%、GPQA 高難推理約 70%,也屬於開源模型第一梯隊。這些硬指標支撐了它在「知識問答 + 邏輯推理」場景的可靠性,也讓開發者願意把 qwen3官網 作為自建應用的底座參考。
安裝
透過 qwen3下載 取得的 Android APK 安裝包,最新版本 1.9.0、包體約 40.53M,在同類 AI 助手屬於體積偏輕的一款——這得益於它採用了 MoE(Mixture-of-Experts)架構,激活參數相對較小,預載的語言資源也做了壓縮。安裝方式與一般第三方 Android 應用相同:下載 APK 後,在系統設定中允許對應的應用來源,點擊安裝即可。由於包名為 ai.qwenlm.chat.android,部分較舊的 Android 版本(8.0 以下)可能會因不支援新的打包簽章標準而無法安裝,建議確認系統版本在 Android 8.0 以上。
首次啟動後,應用會彈出隱私協議與權限請求(儲存空間、網路權限),同意後進入主介面。多數功能需要聯網使用,若有離線使用需求需在設定中提前下載對應的離線模型包——離線包體積較大,建議在 Wi-Fi 環境下進行。已註冊阿里雲或淘寶帳號的使用者可直接一鍵登入,新使用者也能以訪客身份試用部分功能。
本地部署與量化加速
如果說手機 App 是 qwen3 的大眾入口,那麼本地部署則是技術用戶的主力玩法。AWQ 量化是目前最主流的 4bit 方案,它的核心思想是對每層權重做重要性分析、保留絕對值最大的 1% 為 FP16 以避免顯著精度損失,其餘 99% 量化到 4bit。以 qwen3-8B 規格為例,原生 FP16 約 16GB 顯存,經 AWQ 4bit 量化後僅約 5GB——這意味著一張 8GB 顯存的入門級顯卡也能跑得動 8B 規格的模型。
這一能力域的亮點在於「工具鏈完善 + 精度損失可控」。社區已在 Hugging Face 上貢獻了多個規格的 AWQ 量化版,直接用 Transformers 或 vLLM 加載即可;精度方面,4bit 量化在 MMLU 上分數下降僅 1~5%,大模型(32B 以上)幾乎可以忽略。與 GPTQ 相比,AWQ 量化速度更快(不需要重算誤差),在推理生態上兩者持平(都支援 Transformers、vLLM、SGLang)。
適用場景很明確:學生黨或個人開發者只有一張 8GB 或 12GB 顯卡,想在本機跑 7B~14B 規格的模型做學習、驗證或個人助理;小團隊想在自建伺服器上部署私有 AI 服務,不想把敏感資料送到雲端。
通用推理與基準對比
qwen3 的第二個能力域是純推理能力——這也是大模型綜合素質的體現。整理三個核心基準來看:
- MMLU(英文 57 學科):qwen3-235B-A22B 非思考模式約 78%、思考模式約 85%,與 Llama 3.1 405B(約 83%)、DeepSeek-V3(約 82%)同屬第一梯隊;
- C-Eval(中文):qwen3-235B-A22B 思考模式約 90%,顯著超過 Qwen2.5-72B-Instruct(約 78%)與 Llama 3.1 405B(約 73%)——這是 Qwen 系列一貫的中文優勢;
- GPQA(高難科學推理):qwen3-235B-A22B 約 70%,高於 DeepSeek-V3(約 62%)與 Llama 3.1 405B(約 65%)——這說明思考模式下的 qwen3 在複雜邏輯上確實強勁。
除了硬基準,官方還強調了幾個直觀體驗上的改善:指令遵循更穩(不會答非所問)、創造性寫作更自然(少生硬感)、多輪對話一致性更好(不容易忘記之前的上下文)。對於真正把模型當「智能體」而非「問答機」的使用者來說,這些體驗層面的提升,往往比基準上分數差幾個百分點更重要。
雲端接入與安全管理
如果不想自己部署,可以走阿里雲百煉平台的雲端 API 接入——這是 qwen3 最成熟的企業級通路。不過樣本裡特別強調了一個容易被忽視的點:API Key 安全。百煉的 Key 價值取決於餘額,qwen3-max 單價不低,Key 洩露後攻擊者一天就能刷出幾千甚至上萬的費用,而且阿里雲的 API 調用不計入免費額度。
這一能力域的亮點在於「全鏈路安全實踐」——從環境變量管理(Linux/macOS 的 export、Windows PowerShell 的永久設定、.env 文件本地開發)、到用量監控(百煉控制台即時統計 + 阿里雲費用中心詳細賬單)、再到限流保護(服務端預設限流 + 客戶端 limits 庫自保護)、Key 輪換與多 Key 獨立管理(一 Key 一用途),樣本裡給了非常具體的操作指引。生產環境下還建議加上後端代理(Key 只存在伺服器、做額外限流與日誌審計)、VPC 私有網路接入、最小權限原則等進階措施。
適用場景:企業開發者把 qwen3 整合進自家產品或內部工具、個人開發者搭建 AI 應用原型、需要高可用性的線上服務。
多模態視覺與 OCR
qwen3 的第三個能力域是 多模態——qwen3-VL(Vision-Language)系列相比傳統 OCR 工具(PaddleOCR、Tesseract)的區別是「理解能力」:傳統 OCR 只做文字識別、輸出純文本;qwen3-VL 是識別 + 理解,能分析圖表、回答問題、生成摘要。
樣本裡列了幾個典型場景:中文文字識別(含手寫、藝術字體)、表格識別與結構化(直接轉 Markdown)、數學公式識別(輸出 LaTeX)、圖表趨勢分析(含峰值谷值與整體走向)、多圖對比分析、PDF 截頁文檔理解(合同關鍵條款提取)、軟體界面截圖理解。Prompt 技巧上,精確指定輸出格式(如「JSON,字段姓名/日期/金額」)、引導模型關注特定區域(如「右上角的時間戳」)、分拆多步驟任務都能顯著提升效果。
當然也有清楚的邊界:圖片大小有上限、一次請求圖片數有限制(約 20 張)、過高解析度會被自動縮放、對物體檢測的精度不如專門的 YOLO/Faster-RCNN;成本上多模態 API 比純文本貴不少——如果只是純文字 OCR,用傳統工具更便宜也更快。
短板也要說
盤點到這裡,qwen3 的優勢很清楚——中文強、多語言廣、推理深、多模態全、開源友好(Apache 2.0)。但它並非沒有短板:
- MoE 架構在小硬體上的問題:雖然量化後顯存佔用低,但 MoE 的路由計算仍然吃 CPU,低功耗手機或迷你主機上的推論速度可能不如同規格的 dense 模型;
- 生態成熟度仍在追趕:Llama 系列有更豐富的第三方工具與社群資源,qwen3 在英文版的教程與範例數量上還有差距;
- 多模態成本偏高:VL 系列的 API 單價顯著高於純文本,圖表分析、文檔解析這類複雜請求又消耗更多 token,頻繁使用時成本會快速累積;
- Android App 包體不算最小:40.53M 在 AI 助手裡屬於中等偏上,對於裝了很多應用、需要 手機優化 的低端手機,存儲空間可能會成為一個考慮因素。
適用人群畫像
綜合以上四個能力域的盤點,qwen3 大致適合三類人群:
第一類:中文為主的個人使用者與中小團隊。如果你主要用中文交流與寫作,qwen3 在 C-Eval 上的優勢會直接體現在日常問答、文檔生成、代碼註解等場景的響應品質上。手機 App 輕量、雲端 API 靈活、本地部署門檻也因為量化工具鏈的成熟而降低。
第二類:技術開發者與 AI 應用搭建者。無論是想在本機跑模型做學習驗證(量化加速讓 8GB 顯卡也能玩 8B),還是想把 qwen3 整合進自家產品(百煉平台 + OpenAI 相容介面 + 全鏈路安全實踐),都有成熟的路徑可走。MoE 架構帶來的參數效率優勢,在需要同時支援多語言的場景下尤其可觀。
第三類:有圖文混合處理需求的從業者。比如財務人員要把發票掃描件轉成結構化表格、研究人員要從論文 PDF 中提取公式與關鍵結論、產品經理要分析競品截圖的界面結構——qwen3-VL 的「識別 + 理解」能力比傳統 OCR 工具省了大量後續手動整理的時間。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。