驗收單 · 2026-10-22 · 约 8 分钟
Voicechanger 變聲背後:先存底、後疊效果的架構邏輯
| 軟體 | Voicechanger | 分類 | 影音播放 |
|---|---|---|---|
| 版本 | 1.02.76.0219 | 體積 | 30.40M |
| 開發方 | 暂无资料 | 狀態 | 已歸檔 |
Voicechanger 是什麼,能幹嘛
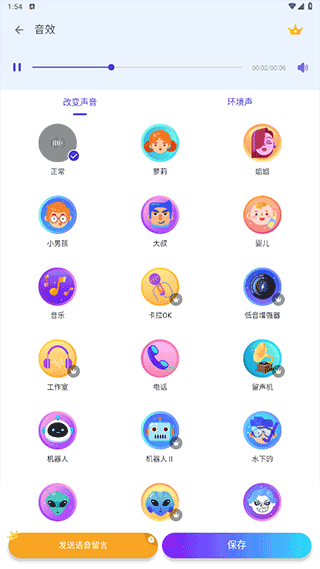
Voicechanger 是一款 Android 平台的趣味語音變換工具,內建數十種預設聲線——蘿莉音、御姐音、機器人、幽靈、大叔——外加多語言即時互譯核心,目標場景覆蓋手游開黑配音、短影片創作、社交聊天整蠱。
但這次我不想聊「哪款聲線最好聽」——真正引起我注意的是它在錄音環節做的一個反直覺決定:先存乾聲,後疊效果。市面上多數變聲應用是錄音的同時把變聲 DSP 效果直接寫進音檔,錄完就定死了,選錯聲線只能整段重錄。Voicechanger 偏要把兩步拆開,乾聲永遠是乾聲,聲線、環境音、參數可以無限次換。為什麼它敢這麼做?這個決策在工程上意味著什麼?
安裝
Voicechanger下載 以 Android APK 形式發布,最新版本 1.02.76.0219,安裝包約 30.40MB,這款輕量影音應用的快取管理做得不差。安裝流程就是標準的 Android APK 安裝:從瀏覽器或檔案管理器找到 APK 檔,點擊後系統會彈出「允許未知來源安裝」的提示(如果手機還沒開這個權限,會自動引導到設定頁面開啟),確認後等待安裝完成即可。
首次啟動時會要求麥克風權限——這個一定要點「允許」,不然錄音功能直接不可用。如果之後才發現錄沒聲音,多半是權限被手機系統回收了,去「設定 → 應用程式 → Voicechanger → 權限」手動開回來。安裝本身沒什麼坑,真正要注意的是舊版本殘留:如果你之前裝過測試版或更早版本,建議先解除安裝再裝新包,少數情況下舊版的乾聲快取檔案會導致新版啟動崩潰。
深度原理解析:為什麼它把乾聲永遠留住
問題:變聲應用的核心矛盾
變聲應用面臨一個天然的工程矛盾:效果越豐富,用戶越容易選錯;錄音越即興,錯誤成本越高。用戶錄一句「小哥哥帶我吃雞呀」,選了蘿莉聲線,聽完覺得太甜想換御姐——多數應用的答案是「重錄」。這就是為什麼很多人覺得變聲軟體「好玩但不耐玩」,錯一次就要從頭來。
Voicechanger官網 的解法是把錄音和變聲徹底解耦——我把它叫做「蛋糕胚 + 裱花」架構:乾聲是蛋糕胚,一次烤好永遠在;聲線、環境音、參數是裱花和裝飾,可以換十次、二十次,蛋糕胚本身不變。
拆解:資料流的四層流水線
從按下錄音鍵到保存作品,Voicechanger 內部的資料流清晰分四層:
第一層:乾聲採集(不可逆,只跑一次)。錄音按鈕按下後,Android AudioRecord API 直接把 PCM 原始音流寫入一個臨時檔案,不經過任何 DSP 處理。這個檔案就是所謂的「乾聲」——一段沒有任何效果的純人聲。這一步只做一件事:把聲音從空氣裡抓下來存好。
第二層:聲線變換(可逆,可重跑)。用戶從聲線庫點選一個預設(比如「機器人」),Voicechanger 從 DSP 參數庫裡取出這個聲線對應的參數集——這種把效果參數獨立於 DSP 核心的做法,和很多嵌入式音訊裝置的硬體設計思路一致——包括 Pitch 偏移量、Harmonics 增益、Noise Floor 門限等十幾個參數——然後對乾聲 PCM 跑一遍即時 DSP 演算法,輸出變聲後的 PCM。這一步永遠讀乾聲、不寫回乾聲,所以換聲線時只要重新跑 DSP 就行,原始資料零損耗。
第三層:環境音疊加(可逆,可重跑)。選完聲線後用戶可以疊加環境音(洞穴、大廳、工作室),本質上是把變聲後的 PCM 和一個環境音樣本做 mix。這一層的輸入是第二層的輸出,但同樣不寫回乾聲。
第四層:參數工坊(可逆,可重跑)。五個旋鈕——音調、清晰度、音量、回音、變音強度——本質上是對第二層 DSP 參數的微調。「變音強度」旋鈕最常用,它控制的是「原始聲線參數集」和「參數工坊手調值」之間的加權比例——往右擰就是預設效果全開,往左擰就是往原聲方向收斂。這也是為什麼預設聲線太假時,擰兩下旋鈕就能挽回,而不是要重錄。
取捨:這個架構的代價是什麼
天下沒有免費的午餐。乾聲先存底的設計帶來了兩個成本:
第一,記憶體和儲存空間翻倍。每次錄音會同時存在乾聲檔案和變聲後的輸出檔案,長錄音(超過一分鐘)會佔用兩倍空間。好在 30.40MB 的安裝包本身已經預留了快取空間管理,舊乾聲會在應用冷啟動時自動清理。
第二,每次換聲線都要重跑 DSP。多數情況下是秒級的,但如果你錄了五分鐘的長音、又疊了環境音、又擰了五個旋鈕,每次換聲線的等待時間會拉到三五秒。這就是為什麼它不適合需要即時變聲的場景——比如手游開黑時一邊說話一邊變聲,那種場景需要 DSP 在麥克風輸入時就同步跑,不能等你錄完再處理。Voicechanger 自己也意識到了這一點,它的「聊天變声模式」是另外一條獨立的即時 DSP 流水線,和這套乾聲-效果分離架構完全平行——這種雙流水線的設計也為未來跨平台擴展留了餘地。
判斷:它適合什麼,不適合什麼
這套架構的核心優勢是「創作自由度」最大化——你可以錄一段十秒的乾聲,然後花十分鐘換二十種聲線、疊五種環境音、調無數組參數,直到出現最滿意的效果,這一切的成本只是 CPU 跑幾秒 DSP,不是你重錄二十次。
所以 Voicechanger 的最佳使用場景是後處理創作:短影片配音、遊戲語音包錄製、社交整蠱錄音——這些場景允許你錄完再慢慢修。如果你需要的是「開黑時一邊說一邊變」,那它的架構就不是為你設計的,你會覺得「為什麼我不能即時聽到自己變後的聲音」——答案是:這個功能在它的架構裡需要另一條獨立流水線才能實作,而那條流水線的參數獨立、效果也不能通過參數工坊微調。
小結
把乾聲永遠留住這個決定,本質上是一個架構選型:用儲存空間和非即時性,換取用戶零錯誤成本的創作體驗。多數變聲應用選擇了另一條路——即時 DSP、一鍵搞定、錯了重錄。Voicechanger 選了一條更慢但更自由的路,代價是即時變聲場景的體驗讓步,回報是每一段乾聲都能被反覆雕琢到極致。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。