驗收單 · 2026-10-22 · 约 8 分钟
safebooru 標籤搜尋深度解析——倒排索引如何讓二次元圖庫一秒出結果
| 軟體 | safebooru | 分類 | 摄影图像 |
|---|---|---|---|
| 版本 | 1.0 | 體積 | 3.37M |
| 開發方 | 暂无资料 | 狀態 | 已歸檔 |
safebooru 是什麼——一個貼著無數標籤的二次元圖庫入口
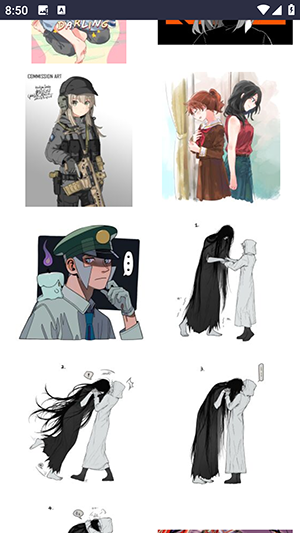
safebooru 是一款專為二次元愛好者打造的插畫搜尋工具,本質上它不是一個圖庫,而是 booru 生態的一個輕量前端。booru 站(如 Safebooru、Danbooru、Gelbooru)的核心特色是:每一張上傳的圖都會被打上數十個到上百個精細標籤——人物、髮色、眼睛顏色、服飾、動作、場景、情緒,甚至構圖和視角。這些標籤構成了一個龐大的標籤空間,safebooru 就是把這個標籤空間的查詢能力打包成了一個 3.37M 的 Android APK,讓使用者隨手就能在圖庫裡用標籤精準定位想要的畫面。
我對這款軟體感興趣的地方,不是它能搜圖這件事本身,而是它的搜尋速度和精準度——在動輒百萬級圖片的 booru 站上,輸入一行標籤組合能在秒級返回結果,這背後是一套設計得相當漂亮的倒排索引機制。
安裝
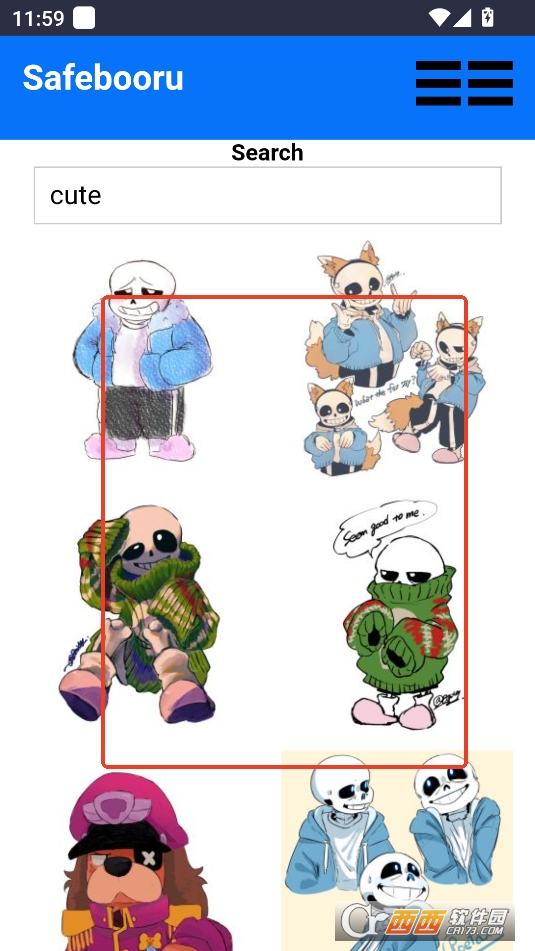
safebooru 的安裝相當直接:它是標準的 Android APK(版本 1.0,約 3.37MB),包名為 com.safeboo.xxrjy。手機允許「未知來源」安裝後,從 safebooru下載 獲取的 APK 直接點擊即可完成。首次啟動不需要額外下載資源包,也不需要註冊或登入——app 啟動後直接進入首頁縮略圖列表,頂部就是搜尋框,可以立即開始標籤查詢。軟體本身不緩存圖片,縮略圖和大圖全部即時從 booru 站拉取,所以手機記憶體佔用也很低。唯一需要注意的是,如果你的手機有省电模式或後台限制,建议把 safebooru 加入白名單,不然長時間搜尋後可能被系統殺掉進程。
標籤搜尋的底層——倒排索引如何把百萬圖片一秒縮小到幾十張
問題:booru 站的標籤搜尋為什麼快
先說直觀感受:我在 safebooru 裡輸入 1girl blue_hair long_hair school_uniform sitting smile 這一串標籤,app 幾乎瞬間就返回了結果。如果這是一個簡單的數據庫查詢,逐行掃描每張圖的所有標籤去匹配,百萬級圖片的場景下這需要幾秒甚至更久。但實際體驗是秒級響應,這意味著 booru 站的後端根本不是在做線性掃描。
答案就是倒排索引。這是搜索引擎和標籤系統的核心數據結構,我用一個生活化的類比來說明:把 booru 站想像成一個超大的圖書館,每本書(圖片)的封底貼著數十張便利貼(標籤)。正排索引就是「從書找標籤」——拿著一本書看它有哪些便利貼;倒排索引則是「從便利貼找書」——拿著一張寫著「藍髮」的便利貼,直接就能找到所有貼了這張便利貼的書。
booru 站維護的是每一個標籤對應的圖片 ID 集合(也叫 posting list),類似 攝影監控 系統中的標籤索引結構。當你輸入多個標籤時,查詢就是在多個集合之間做交集運算——集合的交集運算在內存裡可以用排序合併或位運算高效完成,這種快速 估算 能力讓百萬級圖片的場景下,單個標籤的 posting list 也不過幾萬到幾十萬個整數 ID,交集運算的成本遠低於線性掃描。
空格、下劃線、減號——三個符號的精確語義
素材包裡的四篇樣本文檔,其實都在圍繞倒排索引的查詢語法展開。讓我把它們背後的設計決策拆開來看:
空格 = 集合交集(AND)。樣本裡說「空格分隔的多個標籤必須同時滿足」,這就是倒排索引最核心的運算:取所有匹配標籤 posting list 的交集。標籤越多,交集越小,結果越精準,但也越容易變成空集合——這就是為什麼樣本建議一般控制在 3 到 8 個標籤,太多了交集可能為空。
下劃線 = 原子標籤 key。school_uniform 不是 school 和 uniform 兩個標籤的組合,而是一個不可拆分的原子 key。這背後的設計意圖是避免自然語言的歧義——如果用空格代替下劃線,school uniform 會被解析成「同時有 school 和 uniform 兩個標籤」,但 booru 站根本沒有這兩個標籤(標籤是 school_uniform)。下劃線本質上是把多詞短語序列化為一個可精確匹配的倒排索引 key,消除了自然語言分詞的不確定性。
減號 = 集合差集(NOT)。排除標籤(-school_uniform)是交集運算的逆操作:從當前結果集合裡扣除所有匹配排除標籤的圖片。和正嚮標籤一樣,減號後不能有空格(- school_uniform 無效),因為減號本身就是 key 的一部分——倒排索引在掃描 posting list 之前,先把減號前綴的 key 收集起來做差集運算。
黑名單 vs 排除標籤——持久化過濾器的兩種邊界
素材包裡有一個細節值得注意:排除標籤(搜索框裡的 -標籤)和設置裡的黑名單,效果一樣但作用範圍不同。這其實是同一個差集運算在兩個不同層級的應用:
- 搜索框裡的排除標籤是查詢時注入的差集條件,隨著本次查詢結束就消失了——它和正嚮標籤一起組成本次查詢的布爾表達式。
- 黑名單是持久化的差集條件,booru 站在每次查詢返回結果後,都會把黑名單裡的標籤對應的圖片從結果裡預先扣除,然後把過濾後的結果返回給客戶端。至於用「完全隱藏」還是「模糊顯示」,這是客戶端(safebooru app)的顯示層邏輯,booru 站後端只負責過濾。
這個設計有個巧妙的地方:黑名單在後端過濾而不是客戶端過濾,意味著即使你用其他 booru 前端登入同一個帳號,黑名單也會自動生效——它是帳號級別的持久化過濾器,綁定在 booru 站的資料層而不是某個 app 的 UI 層。
取捨與邊界
當然,這套設計也有它的代價。下劃線作為原子 key 的代價是:booru 站的標籤生態被鎖死在了英文為主的命名空間裡——中文標籤很難進入主流,因為下劃線約定和 booru 最初的英文社區設計是深度耦合的。排除標籤的代價是:每個查詢至少需要一個正嚮標籤,只寫 -furry 會返回空結果——差集運算不能獨立存在,它需要一個基線集合。標籤太多導致交集為空的代價是:新使用者常常會因為不知道精確的標籤名稱而搜不到圖,booru 站因此提供了標籤自動補全和相關標籤推薦來緩解這個問題。
判斷
safebooru 這款軟體的核心價值不在於「能看二次元圖」——這件事瀏覽器也能做——而在於它把 booru 生態的倒排索引查詢能力打包成了一個體驗乾淨的手機端入口。如果你只是隨便刷刷圖,這套標籤體系可能顯得繁瑣;但如果你有明確的審美偏好或創作需求(比如找特定風格的角色設計參考),倒排索引帶來的精準度是任何推薦算法都比不了的。標籤是明確的、可解釋的、完全在你控制之下的,而非依賴黑箱式的 自動化 推薦,這在演算法黑箱氾濫的今天,反而是一種稀缺的設計選擇。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。