驗收單 · 2026-10-22 · 约 8 分钟
Papago 深度解析:即時翻譯背後的離線與雲端雙層架構
| 軟體 | Papago | 分類 | 考试学习 |
|---|---|---|---|
| 版本 | 1.10.15 | 體積 | 128.16M |
| 開發方 | NAVER Corp. | 狀態 | 已歸檔 |
Papago 是什麼
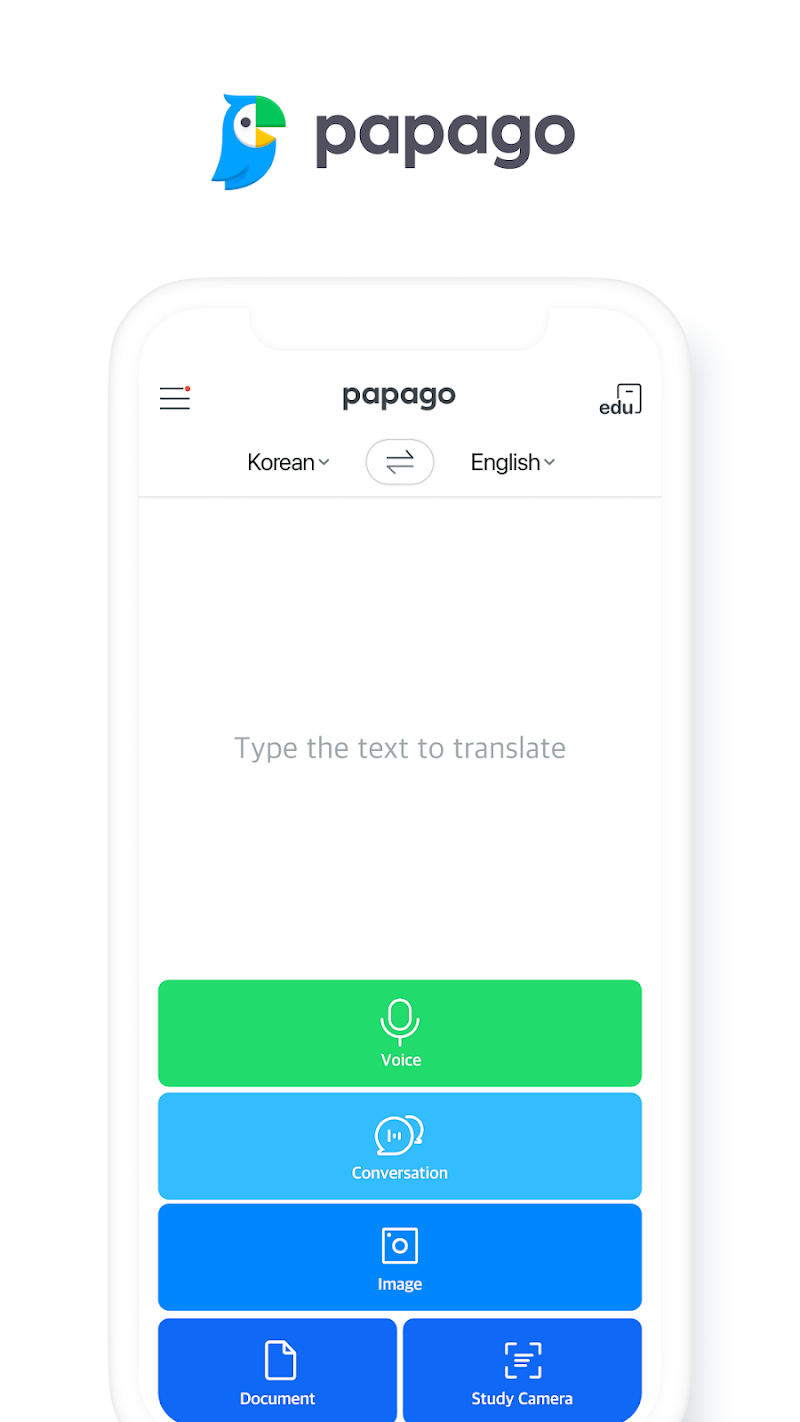
Papago官網 是韓國 NAVER 公司推出的一款 AI 翻譯助手,定位很明確——面向真實世界場景的多模態翻譯工具。它支持文字、語音、對話、圖片、文檔等多種輸入方式,覆蓋韓語、英語、日語、中文等主流語言對。從手機 App 到網頁版再到瀏覽器擴展,Papago 的形態是完整的生態,而不只是一個單點功能。
但如果只說「這是一款翻譯軟體」,其實低估了它的設計野心。在翻譯工具這個賽道上,Papago 的獨特之處不在於它能翻譯——很多工具都能——而在於它刻意針對旅行和離線場景做了架構級的優化。這是我接觸這款軟體後一直想搞清楚的一個問題:為什麼同樣的一句韓文,用其他翻譯 App 在信號不好的地方會卡半天甚至直接放棄,而 Papago 總能在兩三秒內給出結果?答案藏在它的雙層架構裡。
安裝
Papago下載 在 Android 上以 APK 形式分發,目前最新版本 1.10.15,安裝包大小 128.16M,屬於中等體量的應用。安裝過程本身沒有特別之處,但有兩點值得在開使用之前注意。
第一,首次啟動時記得先下載離線語言包。安裝包本身只包含應用框架,實際的翻譯模型和語言數據需要在手機端下載——這是它雙層架構的基礎。如果你計劃在網絡條件差的地方使用(比如韓國鄉下、日本溫泉旅館),這一步千萬別省。離線語言包的入口在左上角菜單 → 離線翻譯,進去後勾選你的目標語言對即可。
第二,權限授予要一次給齊。首次啟動時系統會請求麥克風(語音翻譯)、相機(圖片翻譯)和位置(附近地點信息功能)三個權限。如果你只給了相機權限而拒絕了位置,不會影響圖片翻譯本身,但新版的 AI Briefing 商品識別和附近地點關聯功能就用不了。權限可以之後在系統設置裡補開,但建議首次啟動時一次授權完畢,省得跑到景點才發現功能缺失。
即時翻譯的秘密:為什麼它夠快也夠準
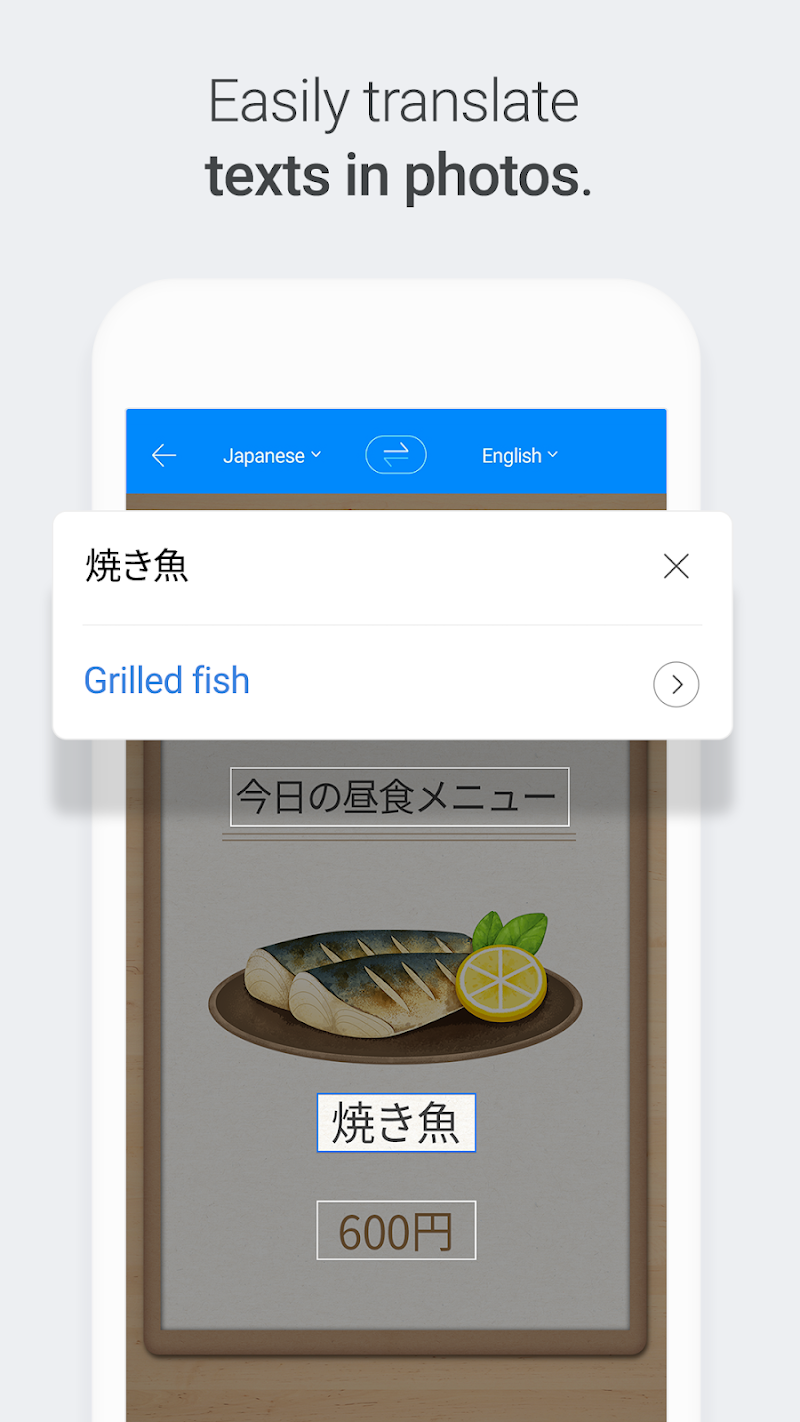
說完了是什麼和怎麼裝,進入正题。我想從一個具體的使用場景切入——在韓國首爾的一家小餐廳,你對著菜單拍照翻譯。整個過程從按下快門到看到譯文,大約花了三秒。這三秒裡發生了什麼?
問題的核心:翻譯工具的三重不可能三角
在拆解 Papago 的架構之前,需要先理解翻譯工具面臨的一個根本問題——準確性、延遲和離線能力,三者不可兼得。
- 想要翻譯準確,就得用更大的模型、更多的上下文,這意味著計算量也更大。
- 想要延遲低,就要讓計算盡可能靠近用戶,最好在本地完成,但本地手機的算力有限,撐不起大模型。
- 想要離線可用,更要把模型壓進手機,進一步限制了模型規模。
大多數翻譯工具在這個三角上選了兩邊:要準確就上雲端,犧牲離線;要離線就用小模型,犧牲準確性。Papago 的設計思路是不選邊,而是分層處理——把不同的翻譯任務分配到不同的層級上去執行。
雙層架構拆解:雲端模型 + 離線語言包
我自己的生活化類比:把 Papago 想象成一個帶著本地嚮導包和遠方情報網的街頭翻譯。你說的每一句話,它先讓身邊的本地嚮導(離線語言包)快速掃一遍,看看能不能直接搞定;搞不定的部分再扔給遠方的翻譯團隊(雲端大模型)去處理,處理完再補回來。
具體到實現上,這套雙層架構的工作流程大致是這樣:
第一層:離線語言包處理高頻、確定性任務。 手機端預先下載的語言包包含經過優化的小型神經翻譯模型和語言規則引擎。對於日常對話中出現頻率最高的幾千個詞和固定語法結構,離線層可以在幾十毫秒內完成翻譯,完全不需要網絡。這就是為什麼在信號不好的地方,Papago 至少能給你一個「不會錯得離譜」的結果——因為高頻部分已經在本地解決了。
第二層:雲端大模型處理低頻、複雜任務。 當遇到專業術語、俚語、長難句,或者圖片翻譯裡的手寫字體時,離線層的信心分數會降到一個閾值以下,這時它才會把任務發送給雲端。雲端用的是 NAVER 自研的更大規模模型,翻譯品質顯著更高,但代價是需要網絡連接和一定的延遲。
這裡最巧妙的設計在於決策邏輯——不是所有任務都需要雲端,也不是所有任務都能離線。Papago 在本地有一個輕量的分類器,對每一次翻譯請求先做一次「這句話離線能搞定嗎」的判斷,根據信心分數決定走哪條路徑。這個判斷本身幾乎不消耗算力,所以你感受到的總延遲才會低。
圖片翻譯的流程則更複雜一些,它實際上是兩個模型串聯工作:先用文字識別模型(OCR)把圖片裡的文字摳出來,再把純文本丟進上面說的雙層翻譯架構。樣本文檔裡提到 AI Briefing 能在翻譯包裝文字後自動生成商品說明——這是翻譯之後再接一個生成式模型做二次處理,屬於架構之上的衍生能力。
取捨:這套設計的代價與邊界
沒有完美的架構,雙層設計也有它的明確代價。
代價一:存儲空間。 離線語言包不是一個小文件——每個語言對的語言包可能達到數百 MB。安裝包本身 128MB,加上下載的離線包,實際佔用空間輕鬆超過 500MB。對於存儲緊張的入門級手機,這是一個門檻。
代價二:首次啟動的等待。 安裝完 APK 只是第一步,真正能用需要下載離線包。如果你的目標語言對比較冷門,下載時間可能長達十幾分鐘。而且這個下載必須在 Wi-Fi 環境下完成,移動網絡下系統會自動禁止。
代價三:低頻詞彙的離線翻譯品質天花板。 離線模型經過壓縮,參數規模比雲端小幾個量級。對於它見過幾十萬次的詞(比如「咖啡」「餐廳」),離線翻譯很準;但對於它只見過幾百次甚至幾十次的詞(比如韓國本土的一些品牌名、日本的地方方言),離線結果大概率不準,這時你只能等雲端處理——而如果當下沒有網絡,那就沒轍了。
判斷:什麼場景適合、什麼場景會失效
綜合下來,這套雙層架構的適用場景非常明確:
- 適合:旅行(語言包預裝 + 雙層處理 = 信號不好也能用)、日常高頻翻譯(離線秒回)、圖片菜單招牌翻譯(OCR + 雙層翻譯鏈路成熟)。
- 適合:不想每次翻譯都等網絡加載,對延遲敏感的用戶。
- 不適合:專業翻譯、學術論文、法律文件這類需要極高精度的場景——即便是雲端模型,也頂多達到「能看懂」的水準,離「能用於正式場合」還有距離。
- 不適合:完全沒有網絡且離線語言包未預裝的突發情況——這種狀況下它會直接拒絕翻譯,什麼都做不了。
說到底,Papago 的雙層架構本質上是一個場景優先的設計決策。它沒有追求在所有維度上都做到最好,而是明確地把資源傾斜到了「旅行 + 日常高頻」這個它最擅長的使用場景上。如果你正好在這個場景裡,它就是目前為數不多讓你覺得「翻譯工具真的能幫上忙」的產品。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。