驗收單 · 2026-10-22 · 约 12 分钟
GoogleGemini 深度解析:思考模式、多模態與 Agent 揉在一個 App 裡的設計哲學
| 軟體 | GoogleGemini | 分類 | AI智能 |
|---|---|---|---|
| 版本 | 25.819.1 | 體積 | 115.96M |
| 開發方 | Google谷歌 | 狀態 | 已歸檔 |
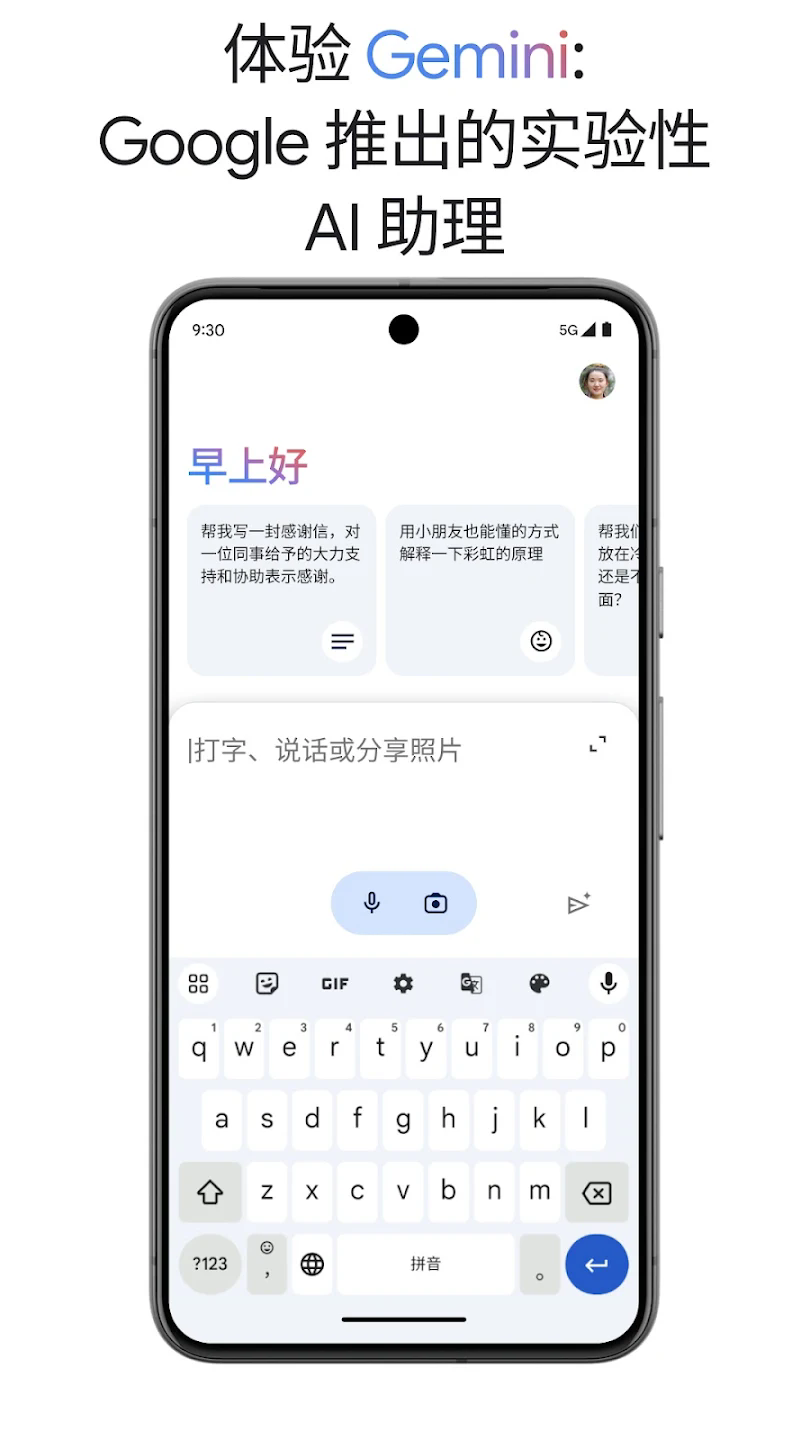
GoogleGemini 是什麼 — 一款把推理、多模態與 Agent 揉在一起的智能對話應用
GoogleGemini 是 Google 推出的跨模態 AI聊天 應用,支援文字、圖片、影片、程式碼等多種內容形式的理解與生成。它不只是一個聊天機器人——從 Nano Banana 產圖、Omni 生影片、Canvas 協作程式碼,到 Spark Agent 每天早上幫你整理 Gmail 與日曆的 Daily Brief,GoogleGemini官網 列出的這些能力,Gemini 試圖全部塞進同一個入口。
但真正讓我覺得值得深挖的不是功能清單,而是它做到這些的方式——一個模型、一套架構、多種執行模式。同樣一個 App,你可以讓它三秒鐘回答「今天天氣如何」,也可以讓它花幾十秒做長程推理、解多變量數學題。這種在速度與品質之間秒級切換的能力,來自 Google 在 版本進化 的 Gemini 2.5 系列引入的思考模式(extended thinking)與思考預算(thinking budget)機制。
安裝
GoogleGemini下載 目前的版本為 25.819.1,支援平台為 Android APK,安裝包大小約 115.96MB,包名為 com.gemini.android.app。安裝過程與一般 Android 應用類似,但有幾點值得注意:
- 系統需求:Google 官方雖未明寫最低 Android 版本,但從用戶反饋來看,Android 12 以下的裝置可能會遇到部分功能不可用的情況(例如 Omni 影片生成需要較新的 GPU 驅動)。
- 首次啟動與登錄:打開 App 後必須用 Google 帳號登錄,Gemini 會自動讀取該帳號的 Gmail、Calendar、Tasks 等服務來初始化 Spark Agent 的能力——這意味著如果你用的是公司帳號,管理員可能已限制了部分權限。
- 思考強度與配額:登錄後的第一個對話建議先去設定 → 思考強度 裡確認你用的是哪個方案。免費版用戶只有「關閉思考」和「標準思考」兩檔,AI Pro / Ultra 訂閱才能開啟「深度思考」,且深度思考會消耗更多配額。
- Library 儲存空間:從 2026 年 5 月的 Neural Expressive UI 改版後,Gemini 會把所有產物(圖片、影片、程式碼、報告)自動歸檔到 Library,佔用你的 Google 雲端儲存額度——AI Pro 含 400GB、AI Ultra 含 30TB,免費版則與一般 Gmail 儲存共享建議定期清理。
為什麼 Gemini 能同時快與慢 — 思考預算的設計原理
我接觸過不少 AI 應用,它們在「快答」與「深思」之間的取捨通常是二選一:要嘛模型小、回得快,但複雜問題容易出錯;要嘛模型大、想得深,但日常問答也要等幾秒。Gemini 的特別之處在於——它把這個取捨變成了一個可以調整的參數,而不是一個固定的產品定位。
這個參數就叫「思考預算」(Thinking Budget)。
思考模式的內部工作流
簡單來說,普通模式下,模型拿到問題後直接開始寫答案 token by token;思考模式下,模型會先預讀問題、拆解成子問題、逐一推理、交叉驗證結論,最後才匯總收斂成正式回答。這個過程對用戶是透明的——你不會看到推理鏈本身,但你會感受到它的品質差異。
官方文件把思考模式的內部流程拆解為四步:預讀 → 展開推理 → 交叉驗證 → 匯總收斂。這和我們熟悉的 Chain-of-Thought(CoT)提示有本質不同——CoT 是你在 prompt 裡「要求模型一步步思考」,但模型是否真的拆了問題、拆得好不好,你無法控制;思考模式是模型在架構層面自動執行的流程,它有固定的驗證步驟來檢查不同子問題的結論是否矛盾。
為什麼這件事重要
這裡有一個容易被忽略的細節:思考預算不是一個二元開關,而是一個可配置的 token 數字。在 API 開發者層面,你可以精確設定「最多花 5000 token 在思考上」還是「最多花 20000 token」;在消費端 App 裡,Google 把它包裝成三種思考強度——關閉、標準、深度——對應不同的預算區間。
我自己的使用體驗是,日常問答用標準思考就夠了,複雜決策(比如幫我分析三個方案的 trade-off)切深度思考,速度確實慢了大約兩到三倍,但答案的結構化程度和正確率有明顯提升。
取捨與邊界
但這套設計不是沒有代價的。思考模式的計算開銷是普通模式的數倍——Google 必須在推理集群裡預留額外的 GPU 資源來應對思考請求的峰值,這也是為什麼深度思考被放在付費方案裡。另外,某些場景下思考模式反而會幫倒忙——簡單問題上它會過度分析、給出冗長的答案;實時語音對話場景(比如在車上用 Android Auto 跟 Gemini 說話)則完全不能用思考模式,延遲不可接受。
一個自己造的類比:普通模式就像你被老闆問「這份報告幾點能交」,你估個時間直接回答;思考模式就像你被問「為什麼我們的伺服器上周宕機了」,你會先拉日誌、查指標、確認是磁碟滿還是記憶體洩漏,然後才給出結論和修復方案。同一個人,不同的問題,不同的處理深度——Gemini 就是把這個判斷權交給了模型自身。
多模態管線 — 從圖片到影片為什麼能共用一套架構
如果說思考模式解決的是「同一個模型在不同難度問題上的表現一致性」,那麼多模態管線解決的是「同一個入口處理不同類型輸入輸出的能力」。
Gemini 家族從一開始就是多模態設計——不像早期的 GPT-4 是先有文字後加視覺模組,Gemini 的架構原生支援圖片、音訊、影片、文字的混合輸入。2026 年 5 月 I/O 發布的 Omni Flash 更進一步,讓模型能從任意組合的輸入生成影片輸出:你可以傳一張靜態照片讓它變成影片、傳一段鋼琴旋律讓它生成配合音樂的抽象動畫、或者傳一段手機錄影讓它把夜晚改成白天加煙火特效。
為什麼這件事在技術上很難
多模態生成模型的核心挑戰在於——不同模態的資料表示方式完全不同。文字是離散的 token 序列,圖片是像素矩陣,影片是時序像素矩陣,音訊是頻譜資料。要讓同一個模型處理所有這些,你需要在架構上做一件事:把所有模態「投影」到一個統一的隱藏空間(latent space)裡,讓模型能在這個空間裡自由組合不同模態的資訊。
Omni Flash 的特別之處在於——它的影片生成不是從零開始畫每一幀,而是基於真實世界的物理規律。讓一隻橘貓在落葉堆裡打滾,它不會隨便扭曲貓的骨骼,而是參考訓練資料裡真實貓的運動模式。這和 Sora 那類「純生成式」影片模型有明顯區別——Omni 更像是「理解了物體怎麼動,然後在這個約束下生成」。
與 Nano Banana 的協作
Nano Banana(圖片生成)和 Omni(影片生成)在 App 裡是兩個獨立工具,但它們共用底層架構。你可以先用 Nano Banana 生成一張參考圖,再上傳給 Omni 讓它變成影片——這條管線在 UI 上是兩步操作,但在模型層面是連續的:Nano Banana 把圖片投影到隱藏空間,Omni 讀取這個表示作為約束條件來生成時序畫面。
Spark Agent — 為什麼 Daily Brief 不是機械拼裝而是真的在思考
最後一條線是 Agent 架構,具體體現在 Spark Agent 的 Daily Brief 功能上。
Daily Brief 每天早上會自動掃描你的 Gmail、Calendar、Tasks,生成一份個性化的今日簡報推送到 App 側邊欄。聽起來好像就是「把郵件+日曆+任務拼在一起」,但實際上 Spark 在背後做的事情遠不止於此:
- 它會判斷哪些郵件是真的緊急(基於發件人、內容、你過去的行為模式),而不是簡單按發送時間排序
- 它會預測日程衝突、計算交通時間、建議可以插入新安排的空檔
- 它會跨郵件理解專案關聯(「這三封郵件都關於 XX 專案,建議一起處理」)
官方文件對 Daily Brief 與舊 Google Assistant「我的一天」做了明確區分——後者只是機械拼裝資訊,前者是真的在思考你的優先級。
Agent 架構的設計哲學
Spark Agent 的架構核心是「工具呼叫 + 思考模式」的組合。Agent 拿到目標(「幫我整理今天要做的事」)後,不是直接開始寫簡報,而是先規劃要調用哪些工具(讀 Gmail API、讀 Calendar API、讀 Tasks API),拿到資料後用思考模式進行交叉推理(這封郵件和那個會議是否有關聯?這個任務是否真的今天到期?),最後才匯總成簡報。
這和早期「把 Agent 當作另一個 chatbot 來做」的思路完全不同——Gemini 把 Agent 能力做成了模型架構的原生擴展,而不是在外面套一個 shell。好處是 Agent 能直接利用模型的長程推理和多模態能力,壞處是每次 Agent 運行都會消耗大量計算資源——這也是為什麼 Daily Brief 只在早上跑一次,而不是全天候待命。
結語 — 同一個模型,三種設計脈絡
回頭看,GoogleGemini 這款 App 背後其實有三條平行的設計脈絡:
- 思考預算讓同一個模型能在速度與品質之間秒級切換,解決了「通用模型 vs 專用模型」的二選一問題;
- 多模態管線讓同一個入口能處理文字、圖片、影片、音訊的混合輸入輸出,解決了「多工具 vs 單一入口」的體驗問題;
- Spark Agent 把工具呼叫做成模型架構的原生擴展,解決了「Agent vs chatbot」的能力邊界問題。
這三條線共同指向一個判斷:未來的 AI 應用不會是「一個模型對一個場景」,而是「一個通用模型 + 可配置的執行參數 + 可擴展的工具連接」。Gemini 可能不是第一個做出這種架構的,但它是第一個把這三件事同時做得這麼完整、這麼消費級化的。
至於這套設計的邊界在哪——免費版配額緊、深度思考延遲大、Agent 數據隱私需要信任 Google——這些都是產品層面需要用戶自己取捨的地方。但從架構角度看,這確實是目前最值得深入研究的 AI 應用設計之一。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。