驗收單 · 2026-10-22 · 约 11 分钟
deepthink 幕後:多模型聚合是怎麼在一個 App 裡跑起來的
| 軟體 | deepthink | 分類 | 办公商务 |
|---|---|---|---|
| 版本 | 1.6.3-8 | 體積 | 16.99M |
| 開發方 | 暂无资料 | 狀態 | 已歸檔 |
deepthink 是什麼
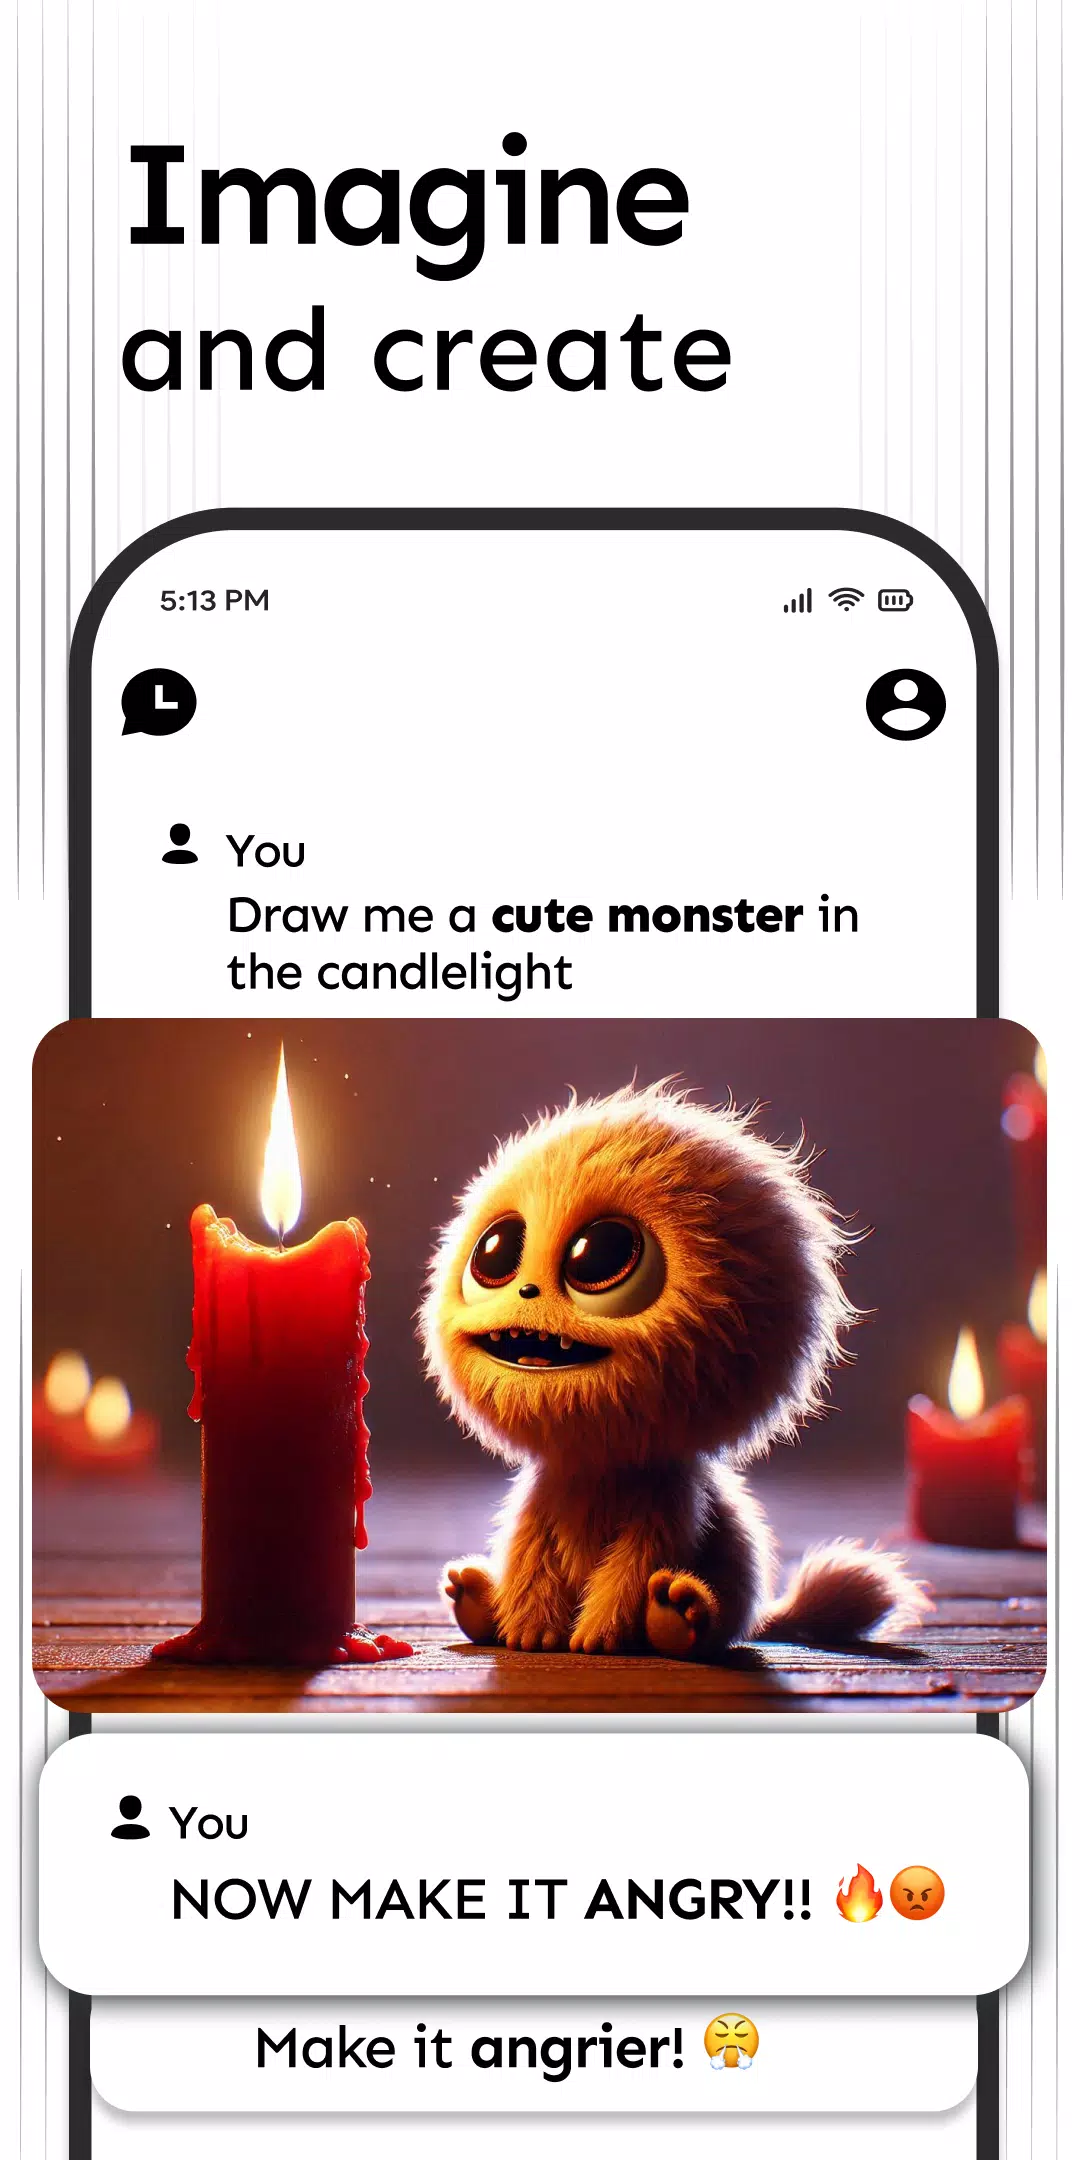
打開 deepthink,第一眼看到的不是某個單一模型的標誌,而是頂部那個可以下拉切換的模型選擇器——ChatGPT 4o、ChatGPT o1、DeepSeek V3、DeepSeek R1、Claude 3.5、Gemini 2.0,還有幾個不太常見的名字排在後面。這不是一款「另一個 AI 聊天 App」,它的定位是聚合器:把多家廠商的模型 API 收進同一個聊天界面,讓你在同一個對話裡按任務切換模型,不用跳來跳去。
我裝過不少聚合型 AI 應用,多數要嘛是做成「多頁籤各自對話」,要嘛是固定把一個模型當主力、其他當備援。deepthink 比較特別——它讓模型選擇從一開始就變成整個交互的一部分,裝完進主界面第一個動作就是選模型,而不是先聊天。這件事看起來簡單,但要把十幾個廠商的 API 對齊成同一套體驗,幕後的設計選擇其實不少。想深入了解各模型的接入細節與版本更新記錄,可以去 deepthink官網 看看完整說明。
安裝
deepthink下載 的安裝包以 Android APK 形式發布,最新版本 1.6.3-8,約 17 MB。整個安裝流程在手機上就能完成,不需要連電腦。
打開文件管理器找到下載好的 deepthink_v1.6.3-8.apk,第一次點開時安卓系統會彈「不允許安裝未知應用」的提示——這是系統對應用商店外安裝包的正常攔截。按彈窗提示給你的文件管理器(或下載 APK 用的瀏覽器)開啟「允許此來源」開關,返回文件管理器重新點一次 APK 就能進安裝界面。
安裝完解包會佔用系統分區空間,建議至少預留 200 MB,避免後續更新或圖片快取把存儲塞滿。進主界面後頂部中間就是模型選擇器,下拉選一個模型就可以開始對話。
為什麼要把十幾個模型塞進一個 App
說到這裡我想拋一個問題:為什麼要做聚合器? 直接去各廠商官方 App 用不行嗎?答案顯然不是「官方 App 不好用」——各家官方客戶端做得都不差。聚合器存在的真正理由,是不同模型在不同任務上的能力曲線差異太大,而且這種差異不是線性的:DeepSeek R1 做數學推理比 ChatGPT 4o 強一個量級,但中文寫作卻不如後者自然;Claude 3.5 處理長文檔的能力是同行最強,但出圖和連網搜索得靠 Gemini。
deepthink 做的事情,本質上是把模型選擇的問題從「用戶手動跳轉」變成「在同一個界面裡按任務路由」。這個設計選擇看起來很合理,但實現起來有幾個繞不開的問題,我來拆解一下。
統一協議層:把十幾種 API 捏成同一套調用
每一家模型廠商的 API 格式都不一樣:有的用 /v1/chat/completions,有的用 /v1/messages,請求參數裡 temperature、top_p、max_tokens 的預設值和取值範圍各有講究;回傳格式裡的 finish_reason、token 統計、工具調用標記,每家命名都不同。
deepthink 在應用和模型之間加了一層統一的協議適配:App 內部所有對話請求都走同一套參數格式,到了網絡層才根據當前選的模型映射到對應廠商的 API。這件事說起來簡單,但有幾個地方會卡住:比如 DeepSeek R1 會回傳 reasoning_content(思考鏈),而其他模型沒有這個字段——deepthink 必須在適配層把它過濾掉或折叠成可選顯示,不然界面會露出一堆用戶看不懂的中間思考步驟。
還有一個更微妙的問題:輸入 token 和輸出 token 的計費單位不同。ChatGPT 按輸入輸出分開計價,DeepSeek 有不同的 prompt 和 completion 價格,Claude 則按整個請求的 token 總量計算。聚合器要把這些差異對用戶隱藏起來,同時又要在 UI 上顯示一個大致可靠的用量統計——deepthink 的做法是在適配層把各家回傳的 token 數據統一折算成「等效 GPT-4 token」,用戶看到的是統一的數字,實際計價則在後台另行處理。
模型路由:什麼時候換、怎麼換
聚合器的核心價值當然是「換模型」,但換的時機和方式決定了體驗的上限。deepthink 的模型選擇器是用戶驅動的——頂部下拉面板列出所有當前可用的模型,用戶自己選。這種設計的好處是透明,用戶知道自己在用什麼;壞處是門檻高,新用戶根本不知道什麼場景該選什麼。
deepthink 顯然意識到了這點,它通過參數配置把模型分了幾個推薦組合——如果你習慣用流程圖整理思路,會發現這種按任務分類的方式和你繪製決策樹的邏輯很像:日常問答預設 ChatGPT 4o 或 DeepSeek V3,數學和邏輯推薦 DeepSeek R1 或 ChatGPT o1,長文檔閱讀推薦 Claude 3.5,多模態(出圖、識圖)走 Gemini 2.0。這種推薦不是強制的——用戶仍然可以在任何對話裡隨時切換,但對新手來說,系統預設的模型已經是「夠好」的選擇。
這裡有一個有趣的設計取捨我想特別說一下:為什麼不做自動路由? 也就是讓 App 根據用戶輸入的內容自動判斷該用哪個模型。技術上不是做不到——deepthink 完全可以在後台跑一個簡單的自動化分類器,對話題做關鍵詞匹配(數學符號多 → R1,出現圖片 → Gemini,長文本 → Claude),然後自動選模型。但 deepthink 沒這麼做,原因我猜有兩個:
第一,自動路由會引入不可預期性——用戶發了一條消息,系統偷偷換了模型,回來的答案風格完全變了,用戶會以為「這個模型今天怎麼回事」。第二,路由的判斷本身就容易出錯——用戶問「幫我把這張圖裡的數據整理成表格」,這是圖片理解(該用 Gemini)還是長文檔處理(該用 Claude)?邊界模糊時自動路由只會讓人困惑。所以 deepthink 選擇了把選擇權交給用戶,系統只做推薦。
聚合器的代價:為什麼它不是萬能的
說完設計,該講代價了。聚合器的美好是「一站打盡」,但代價也藏在細節裡。
第一個代價:模型陣容不穩定。 我在 deepthink 的幫助頁裡看到一句話讓我印象深刻:「模型名單以安裝後應用內下拉裡實際顯示的為準——名單會隨版本更新變動,個別模型也可能臨時不可用。」這是聚合器繞不開的問題——每家模型廠商的 API 可用性、合作授權、定價策略都是變量,deepthink 作為第三方應用沒有控制力。今天你常用的 ChatGPT o1 明天可能就從面板裡消失了,原因可能是應用版本更新換了渠道,也可能是廠商調了授權。
第二個代價:隱私邊界模糊。 對話內容經過聚合器的服務器再轉發到各模型廠商——這比直接用官方 App 多了中間一環。deepthink 官方文檔裡提到聊天記錄「某些版本只存在本地,某些版本可能同步到雲端」,但沒有明確說雲端是否加密、保留多久。我不會在這裡給法律建議,但提醒一下:銀行密碼、身份證號、公司機密這類敏感信息,無論在哪個 AI 應用裡都不該發。
第三個代價:計費的透明性。 前面提到 deepthink 在 UI 上把各家模型的 token 統一折算顯示,但實際計價是後台另行處理的。對普通用戶來說這沒什麼問題——畢竟多數人只是買個訂閱套餐隨便用;但對重度用戶來說,如果你發現自己用 R1 做數學題的次數明顯變多,而賬單也確實比預期高了不少,那可能需要留意一下自己的模型使用習慣。
一套生活化的類比
說了這麼多技術詞,我用一個類比幫你把它串起來:deepthink 就像一個共享辦公室。
共享辦公室把設計師、程序員、文案、法律顧問都收進同一層樓,你在前台掛號時說「我要解決一個數學題」,前台就把你帶到程序員的工位;說「我要設計一張海報」,就帶到設計師那裡。整棟樓的前台、茶水間、打印機都是共用的(統一協議層),你不用跑五家公司找五個人(不用跳五個 App)。
但這棟樓也有問題:有時某個顧問今天請病假了(模型臨時不可用),有時樓裡的網絡是第三方運營商提供的(隱私中間層),最後的賬單是物業統一結算的(聚合計價)。優勢和代價是一個硬幣的兩面,沒辦法只要前者不要後者。
這套設計對誰有用
最後回到判斷:deepthink 這套多模型聚合的設計,適合誰、不適合誰?
如果你是重度 AI 用戶——每天都在跟不同任務打交道:早上寫電子郵件要中文自然(DeepSeek V3),下午做數學題要推理嚴謹(R1),晚上整理論文要長文檔能力(Claude 3.5),周末還要讓 AI 幫你出幾張圖——那 deepthink 省下的切換成本是實打實的。而且它讓你在同一個對話裡就能按階段換模型,不用複製粘貼整段對話到另一個 App 裡。
如果你是偶爾用用的普通用戶——一周才問幾個簡單問題,那 deepthink 的價值就沒那麼大了。裝了之後大概率還是只用預設的 ChatGPT 4o,模型選擇器形同虛設。這時候你真正需要的可能只是「有一個靠譜的 AI 聊天工具」,而不是「十幾個模型任你選」。
deepthink 的設計從頭到尾都是為重度用戶做的——統一協議層讓模型切換成本為零,用戶驅動的路由給了完全的可控性,聚合計價讓多模型使用不會讓賬單失控。代價就是你得接受模型陣容的不穩定、隱私邊界的模糊、以及一點學習成本。權衡之下,我覺得這個取捨是成立的。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。