驗收單 · 2026-10-22 · 约 9 分钟
Agora 深度拆解:為什麼一款手機 AI 對話軟體敢稱自己「完全離線」
| 軟體 | Agora | 分類 | AI智能 |
|---|---|---|---|
| 版本 | 1.3.7 | 體積 | 51.26M |
| 開發方 | 暂无资料 | 狀態 | 已歸檔 |
Agora 是什麼?
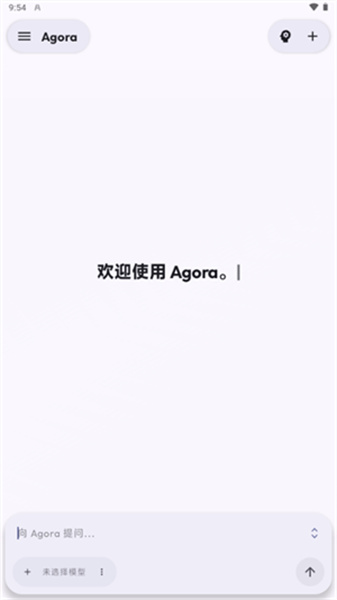
Agora 是一款專為 Android 裝置打造的智能 AI 對話應用,它最核心的承諾就是「不連網也能用」——支援導入多種開源大型語言模型,對話過程中所有資料處理與計算都在本機設備上完成,不會上傳任何訊息到外部伺服器。這在當今大量 AI 應用仰賴雲端 API 的市場格局中,無疑是一個逆向而行的設計選擇。
從產品定位來看,Agora 瞄准的是一群特定使用者:重視隱私、有離線使用需求、或者想在自己手機上真正掌控 AI 行為的人。它不做雲端托管、不收集對話記錄、不強制綁定伺服器賬號——你導入模型、開啟應用、直接對話,整個過程沒有網路請求。這種純本機執行的架構,讓它在眾多 AI 對話應用中顯得格外獨特。
安裝
Agora 以 Android APK 形式分發,安裝包大小約 51MB,對多數中高階手機來說負擔不大。不過安裝前有一個關鍵決策:你從哪個渠道下載?
官方支援三種分發渠道,而不同渠道的版本功能存在實質差異。最顯著的區別在於 F-Droid 渠道版本內建了 Alpine 沙箱——這是一個基於 Alpine Linux 打造的本地隔離執行環境,讓模型可以在沙箱內安全地執行腳本、處理資料,而不會影響系統本身。這個功能在 Google Play 與 GitHub Releases 渠道的版本中都不存在,原因與沙箱依賴的 GPL 組件有關,部分商店的打包規範不便直接整合。
安裝步驟本身沒有特別之處:Agora下載 APK → 允許未知來源安裝 → 完成。首次啟動時需要允許存儲權限,之後你要做的第一件事是完成基本的對話設定並導入一個語言模型——Agora 本身不隨附任何模型,你得自行準備 GGUF 格式的模型文件放到指定目錄。這一步門檻對新手來說可能有些不友好,但也正因為如此,你在選擇模型大小與品質上擁有完全的自主權。
離線運行的底層邏輯
寫到這裡你可能會問:離線運行聽起來很美好,但一台手機怎麼跑得動大語言模型?沙箱、SSH 遠端、排隊狀態機這些功能又是怎麼和離線架構揉在一起的?讓我從一個核心問題開始拆解。
問題:為什麼要「完全離線」?
多數 AI 應用選擇雲端方案是有道理的——雲端 GPU 算力充足、模型更新方便、使用者裝置只負責 UI 顯示。但這個方案有兩個先天缺陷:隱私暴露與網路依賴。對話內容經過雲端意味著第三方可能看到你的訊息;而離線狀態下應用直接報廢,這對需要在弱網或無網環境使用的場景來說是硬傷。
Agora 的設計者顯然把這兩個問題放在了優先級的頂端,選擇了「本地推理」這條更難走但底氣更足的路。
拆解:三層架構如何協同
我把 Agora 的離線架構拆成三個層次來理解:推理層、隔離層、控制層。
推理層的核心是 llama.cpp。這是一個高性能的 C++ 實現,專門針對 CPU 推理優化,能夠在 Android 裝置上跑起從幾百 MB 到幾 GB 的 GGUF 格式模型。llama.cpp 不是「玩具級」的 Demo——它支援量化壓縮、KV cache 管理、並行取樣等完整的推理能力,是目前本地 LLM 推理領域最成熟的開源專案之一。Agora 把 llama.cpp 的編譯產物直接打包進 APK,模型文件放在應用的私有存儲目錄,推理進程與應用主進程分離但共享存儲空間。
隔離層解決的是安全問題。讓模型在本機跑已經夠底氣了,但如果模型要執行代碼呢?直接讓 AI 在你的手機上敲 shell 命令顯然太危險——萬一它誤刪了重要文件怎麼辦?這就是 Alpine 沙箱存在的理由。F-Droid 版本的沙箱在 Android 上劃出一塊受控空間,跑著一個極小的 Alpine Linux 發行版。模型的代碼執行類操作(跑 Python 腳本、驗證代碼片段、處理 CSV 資料)都在沙箱裡完成,出不了邊界。沙箱內的文件與環境是臨時的,重啟後重置——需要持久化產物的話,模型得顯式把結果匯出到應用存儲。
值得注意的是,沙箱與本地推理是兩條獨立的能力。沒有沙箱,llama.cpp 照樣跑模型、照樣離線對話——沙箱只是額外給了模型一個安全的代碼執行環境。而想要對遠端設備執行命令的話,Agora 還有另一條路:SSH 直連。配置好 SSH 設備後,模型可以在遠端伺服器上執行 shell 命令、讀寫文件,而且這個連接是直連不走 HTTP 代理的。沙箱處理本地代碼執行,SSH 處理遠端設備操作,兩者互不衝突。
控制層確保的是互動體驗。Agora 用一套明確的狀態機來管理發送按鈕的行為:空閒時按鈕顯示發送,生成中變成停止,生成中如果有草稿則變成「排隊」模式——你在模型長回覆生成時打字、點發送,消息會自動進入佇列,當前生成結束後無縫接上。v1.3.7 版本還明確規定了一個細節:生成期間的編輯、刪除、重新生成操作全部禁用。為什麼?因為推理進程有時序性,中途改消息會導致模型的上下文窗口混亂——禁用這些操作不是體驗退步,而是防止競態搞亂整段對話。
取捨:好處與代價
任何技術選擇都有代價,Agora 也不例外。
模型體積是第一個現實門檻。llama.cpp 能跑的 GGUF 模型最小也要幾百 MB,想要合理回答品質的話 7B 量化模型通常要 3~5GB。這對手機存儲空間是一個實實在在的考量——雲端方案沒這個問題,伺服器上的模型你看不見也不用管。
推理速度受硬體限制。手機 CPU 與 GPU 的算力遠不如桌面級設備,同樣一個 7B 模型在手機上的推理速度可能只有每秒幾個 token,比雲端 API 慢好幾倍。Agora 支援壓縮模式(Compact)來優化回覆長度,但這本質上是用品質換速度。
渠道功能差異是 GPL 組件的副作用。Alpine 沙箱在 F-Droid 版才有,Google Play 版沒有——這不是功能對比上的區別,而是法律與打包規範的現實約束。想跑沙箱就得從 F-Droid 裝,想要商店自動更新就得犧牲這個功能。兩者無法兼得。
判斷:誰該用、誰該等
綜上所述,Agora 這款產品最適合的人群很明確:
- 重視隱私保護的使用者:對話內容不出手機這一點是硬需求的人——無論是工作上的敏感資料還是個人隱私,本地處理的安全感是雲端給不了的。
- 弱網/無網環境:經常在地鐵、山區、或者網路審核嚴格的地區活動的人,離線AI 比什麼雲端服務都靠譜。
- 愛折騰的技術玩家:想自己選模型、調量化參數、甚至跑多個模型對比效果的人——Agora 的開放性給了足夠的操作空間。
而如果你期待的是「手機上跑出 GPT-4 級別的回答品質」,目前還得等。本地推理的品質上限取決於你選的模型大小與量化程度,而這些受手機硬體限制。Agora 做的是把「本地 AI 對話」這個選項真正變得可用——但可用不等於完美,它在速度與品質上的短板是這個階段的技術邊界,不是產品缺陷。
用一個生活化的類比來收尾:雲端 AI 像是你叫外賣,速度快品質穩但得把地址告訴人家;Agora 像是你家裡的廚房,你知道食材從哪來、怎麼做、不經過任何人的手,但你得自己備料、自己動手,而且廚藝好壞全看你選的食材。兩種選擇各有道理,但對那些「不想讓外人知道自己吃什麼」的人來說,後者才是真正的解藥。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。